我平常會習慣捕捉工作上看到的 “難題”, 覺得有意思, 有研究價值的, 就會挑出來親自想個情境 PoC 練習解題, 這是我快速獲取經驗的方法, 直接面對問題, 排除不相關的環節, 是我嘗試過最精準且有效率的學習方法。 這次碰到了一個新的題目, 就是怎麼有效率的在有正式資料的環境進行測試? 過去工程師的直覺反應就是: 蓋一個測試環境, 然後把資料搬過去…, 但是困難的是這 “資料” 的維持是個很高的開發跟同步成本, 從 infra 的角度切入, 實在沒有太理想的解決方案, 於是, 過去為了解決維運問題我都傾向直接變更設計, 讓你的服務 “天生” 就更好維運的角度設計 (design for operation), 今天面對這問題, 我能否也可以 “design for safe testing” ?
這問題的重要性, 不知不覺的被 agent 放大了, 所以我才開始重新在意這個問題。 最近我都在研究 design for agents 的軟體設計, 影響 agent 行為最大的因素是 context, 而不是過去傳統資訊科學談的資料結構跟演算法… , 當 agent 要代替你操作某套系統 (我拿先前的 Andrew Shop 當案例), 那什麼是操作這系統關鍵的 context ? 就是你系統背後累積的 data, 當你沒有 “完整” 重現這些 context 的時候, 你是測不出 agent 預期的行為的。 單純的功能測試, 有規則可循, 你可以按照情境建立能呈現預期結果的測試資料, 但是 for agent, 就沒那麼容易…, 你至少必須把整體的資料對齊, 到能合理的執行 evaluate 的程度才行…
回過頭來, 目的還是測試環境 + 資料的準備方式, 我決定從搞清楚 “測試” 的意圖開始, 我想走的路線是如何安全的在既有的環境測試, 而能隔離測試造成的影響 (這樣我就不用一直清除測試資料或是重建測試環境) 為主要的執行方向。 我研究了幾個業界的實作案例, 定義自己想要的 “測試” 的邊界跟原則, 最後拿我自己的 Andrew Shop 當作實驗場所實際做一次重構, 驗證結果並且留下的記錄文章。
這個 side project, 是延續先前我在 DevOpsDays Taipei 談的案例, 做法也是延續這個場次提到的 Core Context 做法, 你可以把這篇的內容當作這場演講的延續, 也可以獨立看 Test Mdoe 這個課題來看待.
繼續往下看之前, 多補一段想法…, “手寫” 文章到底還有沒有意義?
現在很少人願意 “親自” 寫文章了, 尤其是這種很花時間的長文… 不過這篇除了中間有兩段, 說明實作的程式碼結構, 以及實際系統 demo 展示的部分我讓 AI 主筆來整理內容之外, 其他是我自己寫的, 只有最後發佈階段讓 AI 替我挑錯字跟統一格式 (這次豪華一點, 圖檔檔名跟 alt text 也幫我調整好了) 而已。 這篇文章定位是我自己學習後的心得分享, 既然是心得, 本來就應該是我消化後再輸出的想法不是嗎? 更何況在整理的過程中我自己也會有收穫, 過去廿年來我也習慣用這種方式累積經驗跟能力了, 如果這些過程對我自己有幫助, 我為何要把這樣的機會讓給 AI 呢? XDD …
另外, 在 AI 開始盛行後, 我也享受到我自己準備這些文章帶來的好處。 我不斷的在提醒大家, 未來最重要的就是 Context 了, 模型, 工具, 做法, skill 等等都很容易取得, 你的競爭對手可以在這些地方都輕易跟你追平, 唯一的差距剩下你的 context 準備的多齊全? 品質有多好? 好的 context 能讓 agent 的表現提高一個檔次, 這才是未來的競爭力, 我自己有過去累積的 400 篇文章, 可以做很多應用, 也可以拿來當 context 餵給 AI 精煉出屬於我自己思考模式的 Andrew-Skills, 因此我不希望我自己貼出來的文章, 會包含我自己都不知道 (沒有仔細 review) 的內容混在裡面…
Context 的品質好壞, 從來都不是 “量” 的多寡, AI 可以輕易生出大量的內容, 但是真正有用的資訊可能只是你給他的 input 而已, 你能生成, 別人也能, 那這些生成的東西通常只是中間產物, 用完可以拋棄了 (可能模型進步了你就會想要重新再生成一次), 生成的東西要有用, 至少要經過一些步驟, 例如你的 review, 加註, 或是調整等等, 否則就會掉到我上面講的, 那別人自己生成就好了..
因此, 我自己大部分工作也開始會用 agent 替我處理了, 唯獨整理心得, 或是整理思緒類型的任務, 包含寫我部落格文章, 我還是會自己慢慢寫, 慢慢梳理調整內容, 因為這是代表我個人想法的 context, 我覺得沒有捷徑可以替代這 “撰寫” 過程跟結果。
以上, 所以不用擔心未來我的部落格會停掉, 或是以後也變成 AI slop 了, 我會適時的用 AI 輔助 (像是這次的測試跟系統重構我就通通都交給 AI 了), 但是這裡絕對不會變成 AI 農場的, 也歡迎長期支持我的讀者門繼續支持 :)
1, 寫在前面, 寫這篇的動機
測試環境的資料, 真的是個頭痛的題目, 過去 QA 的領域中, 特定的行為都需要有預先安排好的 “資料” 才能顯現, 因此 QA 通常都用 scripts 來建立假資料。 好處是很容易重建, 也容易自動化, 但是缺點也是資料 “很假”, “很死板”, 看起來就不像真實資料, 只是包含了各種條件組合的資料, 方便用來驗證各種情境的組合而已。 不過 QA 用途的測試環境也就測試目的在使用, 這倒也不是太大的問題, 直到我開始讓 agent 來代替我操作這系統的時候…
1.1, 從 Data 到 Context
現在的 “資料”, 因為 AI 跟 Agent 的普及, 已經提升到另一個維度了, 他存在的意義不再只是 “Data”, 而是 “Context”; 一個線上銷售的網站, 背後的資料足以講出不同的故事 (ex: 我過去購買的記錄), 不同的人, 可能會因為過去購買記錄的不同, 而影響 agent 後面的回應, 因為整個系統的資料, 在我把控制權交給 agent 替我操作的那一刻, 這些數據就已經變成我個人的 context 之一了, context 會直接影響 agent 的行為, 因此你購買的是 “測試商品20261026” 或是 “TB4 SSD 外接盒”, 對 agent 而言完全是兩回事 。 因為觀察到這些差異, 我先前才會在 facebook 聊 “以後的軟體是寫給 Agent 使用的” 這觀點, 而對 Agent 而言, 比起功能是否完整, 相對的 Context 是否完整會來的更重要且關鍵。
Agent 帶來新的測試要求:
當這些數據, 開始會影響 agent 的行為時, 你開始會想要拿正式環境的資料來進行 “測試” … , 因為 “假資料” 已經不足以讓 agent 能模擬他該有的行為了 (因為 agent 會真正意識到你只是在 “測試” 而已, 不會認真回答你), 因此開始會面臨資料如何搬移到測試環境的問題。 當資料複雜到某個程度, 搬移的成本高到不足以負荷, 如何的把測試行為 “安全” 的移到正式環境, 反而事個合理得做法了。
以這個案例來說, 你要避免的是 agent 在正式環境 “很貼心的” 幫你下單了, 這時你會希望你的信用卡會扣款嗎? 你會希望商品真的被出貨嗎? 你會希望庫存真的扣掉你的訂購, 然後讓真正的客戶買不到商品嗎? 如果你真的能有理想的系統性方法, 可以有效率且 “安全” 的在 “正式環境” 驗證, 那這些問題就都會被解決掉, 才是理想的系統設計。
這是新時代的新測試需求, 而這樣的需求越來越難迴避了, “能否拿正式環境的資料來測試?” 這題目對我而言又重新拉上檯面。 我開始朝向這條路線找解決方案。 最一開始我找的路線是 TiP (Testing In Production environment), 在正式環境上面做功能性測試的技巧; 後來我才搞清楚, 我真正需要的是補強在產品上面執行 “測試操作” 的做法支援 ( Dry Run, or Test Mode ), 兩者其實要解決的 “測試” 意圖並不相同…
1.2, 三種不同的 “測試” 意圖
中文的用語有時不大精準, 以前我常常拿 “問題” 當作比喻, 英文的 “問題” 可能有 Question 跟 Problem 兩種說法, 一個是詢問需要回答, 另一個是異常狀況需要被解決, 只用中文來表達很難講的清楚。 同樣的 “測試” 也可能包含不同的意圖, 我從目的來分類的話, “測試” 其實有三種不同的意圖包含在內:
-
測試要驗證的是 “新功能”:
我開發或修正了新功能, 我怎麼確保他能 “安全” 的部署在正式環境? 我可以建立測試環境, 測過沒問題再上版, 如果碰到資料問題, 則用 feature flag, 上版到正式環境再測, 壞了可以關掉退回舊版, 下次再來, 規模大的話就用金絲雀部署, 先部署幾台, 觀察沒問題再部署全部。
總之, 不論方法, 目的都是確保 “新功能” 最終能順利的全面部署到正式環境的手段
-
測試要驗證的是 “新客戶”:
你需要的是讓新客戶使用正規的功能 (早已測試過, 成功部署到正式環境的), 但是客戶還沒正式簽約, 你必須有限度的約束他的行為, 只讓他做出 “測試” 行為; 目的是控制成本或是影響範圍, 如果是交易系統, 就要控制不真正扣款, 不真正出貨, 業績不會真正列入計算等等, 這通常跟產品的設計有關, 必須包含在功能設計的範圍內
-
測試要驗證的是 “新開發人員”:
這情境跟 (2) 有點相似, 都是讓其他人能安全的 “測試” 你的系統功能, 只不過新客戶測試的是 “使用”, 而開發夥伴測試的是 “API” 串接, 結果都需要某種程度的控制成本或影響範圍。 使用對象不同, 但是要控制的結果很相似, 基本上 (2) 跟 (3) 可以一起考量
搞清楚這三種 “測試” 之後, 我開始抓到中間的差別了, 我意識到我真正需要的是在正確的維度上做到 “隔離”, 隔離邊界的拿捏看來是很重要的決策, 我決定先繼續做完研究, 再回頭來思考我自己的邊界該抓在哪裡。
1.3, 執行路線的選擇
把測試的目的想清楚後, 差別在於關注的重點不同, 我重新思考我的關注點該挑選的解決方案。 以我有限的經驗能理解的範圍, 至少有這兩種路線可以解決我的問題:
-
測試環境隔離:
其實大部分團隊都會準備測試環境, 其實只差完整的資料來測試了。 這種做法你隔離的是 “執行環境”, 而資料也一起被隔離了, 因此你只能找方法在這環境下 “重建” 資料。 你可以用腳本重建, 或是從生產環境搬過來 ( 要定期, 持續搬移, 關鍵在搬移的完整性有多高 ), 這路線不需要變更既有的產品或服務設計, 但是需要投資在資料的抄寫, 這方法技術門檻不難, 但是很煩人, 多個功能可能就有新的資料搬移方法要開發, 你不但要負擔一次性的資料搬移工具的開發, 還有負擔每次轉移產生的費用 (例如數據傳輸, 或是轉檔的運算能力等等)。 -
測試結果隔離:
如果我不希望建立獨立的環境, 那我只能隔離測試的行為跟結果了, 那這是 Test Mode 要解決的題目。 我最初研究時, 想的是完全隔離測試操作的影響, 像很多 CLI 提供的 “Dry Run”, 讓你知道操作正不正確, 但是不會真的造成改變 (這是直接略過結果, 因此後段的流程全部都不會跑); 後來在 Andrew Shop 的實作規格中, 我做了取捨: 我允許測試結果的產生, 允許保存購物車, 結帳與訂單等變更, 但以不產生真實商業效果為底線。
要做好 Test Mode, 重要的是要變更系統的設計, “安全” 的在生產環境進行測試 ( 要變更系統架構設計, 關鍵在隔離能力有多安全 ) 是押注在大規模的重構, 需要對業務情境高度掌握, 相對難度高, 但是設計得當能一勞永逸。
這是兩個不同的路線選擇, 想清楚之後, 在產品內支援 Test Mode 的做法, 才是我想研究的方向, 因此業務需求的掌握跟系統架構的設計會是主要成敗關鍵, 我想練習的是: 該怎麼掌握這樣的需求來規劃架構? 下一步, 我先搞清楚所謂的 “測試” 的目標跟意圖到底是什麼? 再來則是不要閉門造車, 就要先找找業界大廠是否有可參考的案例?
2, 業界做法研究
接下來, 就是找大廠的參考案例了, 我找了有代表性的三家: Salesforce / Shopify / Stripe, 剛好是三種完全不同的 patterns.
我覺得挺有意思的, 這三家的差別, 不在技術能力的優劣, 三家都是國際級的大廠, 我覺得都在水準之上了, 這三種模式, 反應了三家公司的業務需求跟技術選型的不同… , 我就逐一來說明一下:
2.1, Salesforce
Salesforce, 提供企業層級付費的 Sandbox
Salesforce Sandboxes 官方介紹
Salesforce 是 SaaS 模式的領導廠商, 他同時也服務很多大型客戶, 提供高度客製化的服務, 他們的做法是: Sandbox, 提供完全隔離的環境, 這裡 “隔離” 的單位是整個 site, 建立獨立環境後, 依方案幫你複製正式環境的設定與資料, 讓你一開始就有看似一樣的環境可以體驗。
基本上就是讓客戶花錢買獨立的環境建置, 客戶會得到一個一致的 site, 有真實環境資料, 設定; Salesforce 會幫你搞定 replicas 的問題, 能放心測試; 正式環境的資料可依方案抄寫過來, 測試後的設定與程式變更也能選擇性的部署回去…
這堪稱理想的方案, 但是代價就是用成本堆出來的, 以自建獨立環境來推估, 基礎建設的成本是額外的 (可能要 2x, 甚至更多, 測試環境可能沒有那麼多客戶來分攤一次性成本), 額外的跨環境 Replication 機制的設計開發, 以及每一次執行資料遷移都是額外成本 (每增加一個新功能, 你就要檢查新功能能否正確的被複寫)
不同方案支援不同程度的資料複製; Change Sets 部署的是設定與程式等 metadata, 不包含一般業務資料。詳見 Sandbox 類型, Change Sets, 定價。
2.2, Shopify
Shopify, 提供開發者替客戶建立 Client transfer store / Development store
Shopify 商店類型官方說明
Shopify 嚴格的說, 算是 e-commerce 領域的 PaaS 領導廠商了吧, 他把線上商店必要的系統都開發好了, 高度 API 化, 也培養了很多有開發能力的合作夥伴, 替他開發各種 APPs 來擴大生態系。 這種服務類型, 他也提供了合適的 “測試” 解決方案… 做法是: 建立免費的測試商店, 需密碼存取, 只限模擬交易, 無法使用真實世界的金流; 這裡也是在做 “隔離”, 只是隔離的單位是 “store”, 不同的是 store 的設定, 某些功能 (金流, 交易) 會被關閉。
Shopify 特地為了 Partner 準備了這樣的服務: 你可以替客戶開一個 Client transfer store, 沒有額外的費用 (真佛心), 而且這 Shop 將來是可以直接轉移給客戶使用的, 在這個模式下, Client transfer store 跟一般 live store 在功能上有這些差別:
- 免月費
- 強制密碼保護 (一般訪客無法直接瀏覽, 需要密碼)
- 只能使用模擬金流 (無法真實處理信用卡付款)
這是個對開發者很友善的設計, 雖然背後是有成本的, 不過 Shopify 大概是想說這些將來都能轉換成真的客戶, 所以不收費, 從對外呈現的功能來看, 我推測是以 store / tenant 為邊界做隔離, 至於底層是否另外拆成獨立 cluster, 公開文件沒有交代。 但是不管怎麼看, store 層級的隔離, 比 salesforce 的隔離來的輕量不少, 實作跟維護的成本應該更低, 但是設計的角度也更往 APP 端移動, 而不是 infra 端。
這邊我開始看到很明確的 “業務邊界”, 就是交易。 有一條明確的界線絕對不能跨過去, 就是金流跟交易; 在轉交客戶並啟用正式交易前, 這間 Client transfer store 只能使用測試金流, 同樣的問題也會發生在業績計算, 發票, 物流等等 (模擬交易不應該開發票, 也不應該觸發真正的物流機制) … 不過, 對於 “測試資料” 的搬移, Shopify 則沒有進一步的著墨, 推測這些服務就是讓搬店工具, 或是 Partner 來替客戶解決吧, 並不包含在原始的服務內容下。
實際上 Shopify 是有區分兩種測試商店的, 包括 Dev stores 與 Client transfer stores 這兩類, 差異我就不往下挖, 有興趣參考官方的說明: 現行商店分類, 限制說明
2.3, Stripe
Stripe, 靠 API token 來決定 Mode, 可以讓開發人員不需真實金流就能測試完整交易流程
Stripe 測試指南,
Stripe 測試環境與使用情境
Stripe 算是 Payment 支付的領導廠商, 雖然台灣不在服務範圍內, 但是他做的夠好, 我還是有花點時間研究他的做法。 他的做法比起 Salesforce / Shopify 更細膩, 做法是: 同一套 API 透過不同 key 選擇正式/測試用途, 正式付款跟測試付款都會走完相同流程, 測試付款不經真實金流網路。
對我看來, Stripe 也是在做 “隔離”, 隔離的單位是不同模式的 API 物件與交易資料, 巧合的是, Stripe 也把這隔離單位稱作 Sandbox …
這裡先談官方所稱的 test mode sandbox, 看文件說明, 應該是在同一組 API 背後, 靠不同的 APIKEY 區隔 Live Mode 跟 Test Mode, 兩者會共享 account 的部分設定, 但文件說產生的交易資料是完全隔離的, 不會互相參考, 測試的交易也會走完完整的流程, 對開發者來說是最無痛的做法, 換掉 APIKEY 就可以切換到正式環境。
而測試資料的隔離 (例如帳務等等相關功能) Stripe 端都已經處理妥當, 你可以在同一個 account 內測試, 不讓測試交易混入正式帳務; 不過調整共用設定仍可能影響 live mode。 其他 general sandboxes 則隔離設定與資料, 詳見官方比較。
Stripe 隔離涵蓋 Customer, Product 等 API 物件, 不只交易。本次查閱的官方文件沒有揭露 database/table 的實體配置; 測試卡也不會把 live key 的請求自動轉成 test mode。不能由此推論它免除了測試資料準備。API 模式判定, 物件隔離規則
3, 背後的設計模式解析
整體來看, 大家都是在不同邊界做好隔離, 不同廠商的背景, 不同的設計 , 不同的做法 , 帶來不同的隔離層級, 同時也帶來不同的抽象層級, 有著完全不同的實作方式…
整體看來, 我覺得 Stripe 的設計最貼近我的需求, 雖然背後資料是分開的 (文件這樣寫), 但是在介面上, Stripe 最大化做了整合, 包括:
- Dashboard 是同一個 (但是你要切換 Sandbox / Account)
- API endpoint 是同一個 (依靠 APIKEY 來區隔)
- Webhook 接收 URL 可以共用 (事件會標記
livemode判定用途, test / live 使用不同的簽章 secret), 詳見官方說明 - Report / SQL 明確的區隔 (看起來 Report 不會跨 mode 查詢, 部分 Report 只支援 live mode )
其實這就做的很棒了, 感覺背後也是有 Sandbox 的設計, 但是外面的介面看不出來。 對比 Stripe, Salesforce / Shopify 對外呈現的是 org / store (tenant) 層級的隔離, 至於背後是否有獨立的 cluster, 公開文件也沒有交代; 至少 Stripe 讓開發者最大化的感受到這是 “同一個” Account .. 體感上能做到 “我在我申請的正式環境上測試”, 而這些機制的安排不會讓我的帳務錯亂 的效果。
我相信這是開發團隊深思熟慮後的結果。 業界的設計案例研究到這邊告一段落, 我大概能理解各大廠的隔離結構了, 下一個問題是:
Think:
如果我要替我的 Andrew Shop 做類似的設計, 我會怎麼做?
就應用, Andrew Shop 比較貼近 Shopify, 但是就做法, 我比較喜歡 Stripe 的 DX …
我先濃縮設計的取捨, 我覺得每個大廠都是在做這兩個決定, 只是他們的答案不同而已; 同樣的, 我需要決定的是我的 Andrew Shop 這兩個問題的答案應該是什麼?
我先參考了 Dry Run 的設計方式, 支援 Dry Run 用法的 CLI, 通常都有明確參數 –dryrun 代表這次指令要 “啟用” Test Mode, 而 Test Mode 跟 Live Mode 差別在哪, 則由個別的功能自行定義; 背後的設計大致上是: 主結構統一控制 mode (live mode or dry run mode), 而個別功能則要支援不同模式的差別行為, 好處是複雜流程, 因為統一控制, 所以不會碰到 A 功能走 test mode, 而 B 功能走 live mode 的狀況;
但是執行單一任務的 CLI 可以這樣簡化設計, 提供完整服務的 Andrew Shop 不同, 需要更妥善的架構規劃。 我先以此為基礎, 我覺得關鍵決策至少要包含這兩個:
- 明確的界定測試的邊界在哪裡 ( Live Mode / Test Mode 的邊界 )? 要依據什麼原則來決定這兩種 Mode?
- 明確的界定行為差距 ( Test Mode 邊界內的行為要有哪些不同的定義? )
我用一張對照表, 把前面三個案例, 用這個視角擺在一起看:
| 案例 | 隔離邊界: 在哪個範圍內測試? | 行為差異: 測試時有哪些不同? |
|---|---|---|
| Salesforce | 環境 (Environment): 建立與正式環境分開的 Sandbox。 | 複製設定與資料: 依方案將正式環境的設定與資料複製到 Sandbox, 在獨立環境內測試。 |
| Shopify | 商店 (Store / Tenant): 以不同商店區分正式與測試用途。 | 限制部分功能: 依商店類型限制真實付款等功能, 使用模擬交易進行測試。 |
| Stripe | 帳號下的模式 / Test Sandbox: 在同一個 Account 下區隔正式與測試資料區域, 透過不同 API Key 選擇。 | 模擬付款行為: 透過相同的 API 介面測試付款流程, 但不產生真實扣款。 |
| Andrew Shop | (TBD) | (TBD) |
我希望 Andrew Shop 的這兩個決策的答案是? 這部份其實是我自己的 “決策”, 我可以許願:
交易部分我想要像 Stripe 能明確隔離正式與測試的交易結果
很難建立或是累積的資料 (例如上架商品等等) 部分, 我想要共用
所以, 從我的角度來思考, 我的答案是:
-
針對 “交易” 範圍隔離 ( checkout, orders ),
這範圍內依據交易的執行者 ( customers or credit 來識別 ) 來決定是否為 test mode -
“交易” 資料依用途隔離儲存與查詢,
既然強調隔離, 代表應用端不特別處理就不會互通;
Stripe Dashboard 的合併結果, 是另外開發跨區查詢後才彙整的, 其餘資料共享, 會對實際真實業務產生影響的操作只限定 live mode 能執行
因為上架商品跟庫存資訊我不打算隔離, 因此是共用的, 那難題來了:
我用 test credit card 買了一件商品並完成結帳成立訂單, 那我到底要不要扣掉庫存?
庫存, 屬於商品的 “記錄”, 我是把他歸類在 “共用” 資料的範圍的, 兩種模式通用才對, 那麼測試模式下的交易執行時, 到底該不該扣掉庫存? 扣了的話, 測試訂單不收錢, 不出貨, 但是庫存扣了就間接影響實際銷售了 (有貨但是不能賣); 不扣的話變成要有額外的規範來約束測試行為怎麼影響共用資料的原則。
想了很久, 我決定多了第三條原則 (憲法):
- 測試的行為, 絕對不能影響真實業務的進行,
(隔離的邊界: 真實業務影響, 任何違背這條規則的設計都視為不合格)
我用這原則, 來收斂這個現象, 因為 “庫存” 會影響 “真實業務行為”, 會影響客戶能不能夠買這商品。 這案例踩到 “影響真實業務” 的行為了, 那麼測試交易就應該避開, 只留下 LOG 交代, 其他照舊。
以前面的例子來說明, 正式交易成立時應該扣掉庫存, 正式訂單成立應該要發動履約 (出貨, 寄送); 而這些行為在 Andrew Shop 則讓他略過, 這不是對錯, 這是選擇, 我做了選擇可以專注在 “交易執行過程” 的測試, 而這選擇犧牲了後面的測試 (因為被略過了)
切記, 這不代表我這樣做才是對的, 這是因為我知道我的重心在交易的測試, 所以選擇犧牲了其他的測試要求, 比起 “完整” 的設計, 我更在意我有沒有能力依據需求來做正確的設計 / 選擇? 未來有 AI 輔助, 知道怎麼選擇, 比知道完美的設計是什麼更重要, 這些權衡跟取捨, 才是跟 AI 協作的關鍵…
因此, 我把這次要重構變更的範圍想清楚了, 需求濃縮成一段話, 就是:
- 隔離測試的交易資訊, 需要有獨立的儲存方式 ( database, table, storage ), 範圍為 checkouts, orders
- 發動交易端需要有明確的識別 ( .isTest ), 建立後不可變更 ( member , payment id )
- 測試模式必須略過指定的行為, 略過的操作必須在 logs 內說明
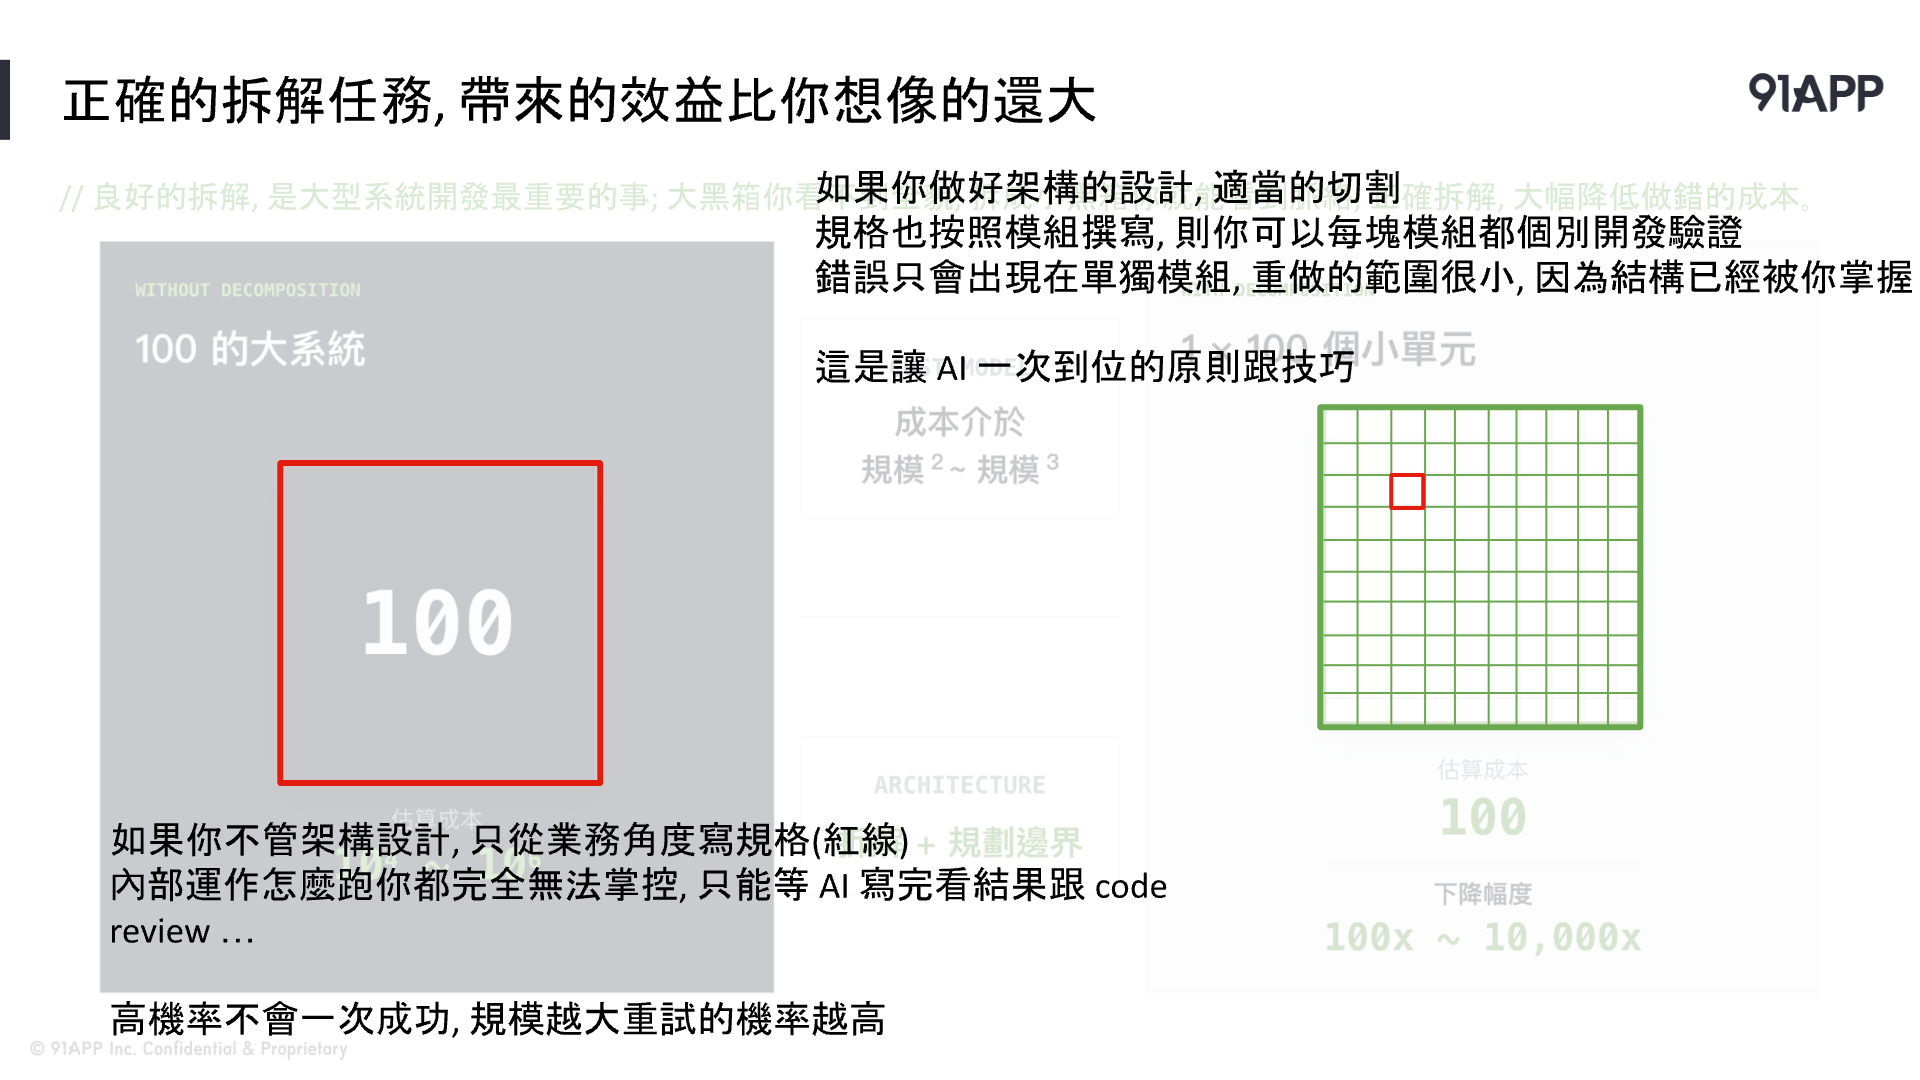
我覺得整個研究, 對我而言最有價值的就是這段 “規格” 了, 要是沒有前面那些研究過程, 我是開不出這樣精確的規格的。 掌握規格跟背後的意圖, 你才能期待 AI 做出來的東西是 100% 符合你預期的; 定義邊界規格, 是拆解整個系統 (大黑箱) 的方式, 所謂模組化切的那一刀, 就是切開的那個邊界規格應該是什麼, 定不出來就代表你沒能力切這刀。
呼應到我提到的簡報 DevOpsDays Taipei 2026 簡報: 黑箱解構(第 29 頁), 談的就是這件事。 如果你有能力定義邊界規格, 你就有能力把一個大黑箱拆成獨立的小黑箱 (右半), 而 agent 有很可靠的能力替你把每個小黑箱實作完成, 因為有邊界規格的防護, 你非常容易驗證, 調整, 並且替換, 掌握邊界規格的人就是掌握整個系統結構, 這是架構師的主要任務, 也是我這頁簡報真正想要表達的想法:
4, 按照設計, 實際開發
到了這個步驟, 就是要考量 Andrew Shop 目前的架構, 如何達成前面開的需求規格。 我把三條需求, 用系統化的角度重新列一次:
- 依據交易執行者 (ex: 指定的測試帳號, 指定的測試卡號), 區隔正式與測試的交易行為 (結帳, 訂單)
- 明確隔離 “交易結果” 的記錄儲存與查詢, 預防資料庫操作的誤區 (ex: 下錯過濾條件導致查詢錯誤, 需要明確跨表 / 跨資料庫查詢才能取得兩類的交易結果)
- 測試交易的結果不能產生真實商業效果 (ex: 產生真實的金流, 物流, 或是會影響銷售金額或是庫存等結果的行為)
其實我大可以把這需求, 直接丟給 agent 替我處理, 現在 agent 的能力應該都能確實做到沒有問題, 不過如果這是真實專案, 會有更多環節需要考量, 包括未來跟其他團隊或系統的銜接做法等等, 過去的經驗都告訴我, 在這個階段我得做更多確認才行, “能夠執行” 只是最基本要求, 不是唯一的要求。
實際做法其實差異並不大, 唯一要注意的是 “邊界” 你需要明確的定義, 同時你也要 review, 只有這樣你才能掌握所有跨越邊界的行為是否如你預期。 真正做起來很單純, 我就是 top -> down 往下挖, 一層一層展開, 挖掘的深度就到我想要的抽象化層級為止就好。 守好邊界, 後面就算做歪了影響也都是局部的錯誤, 局部重做就好。 我分兩個階段進行, 一個是把規格收斂成能夠系統化執行的程度, 收斂成 6 項明確的原則 (4.1); 另一個則是把設計展開, 實作時則規劃三個機制 (database schema, isolation context, boundary query), 真正套用到現在的系統架構下 (4.2)。
拆開來看三個機制的設計:
Schema: Schema 很明確, 就是儲存這些資料的原則, 我希望在 schema 設計之初就做好隔離規劃, 最大化避免後面重要的資料分析, 避免誤用把測試資料也統計進去, 因此 Schema 跟 Boundary Query 很明確, 一個是怎麼儲存時就隔離測試資料, 另一個是查詢時按照 Schema 只認可正式環境的交易資料來計算業績。
Isolation Context:
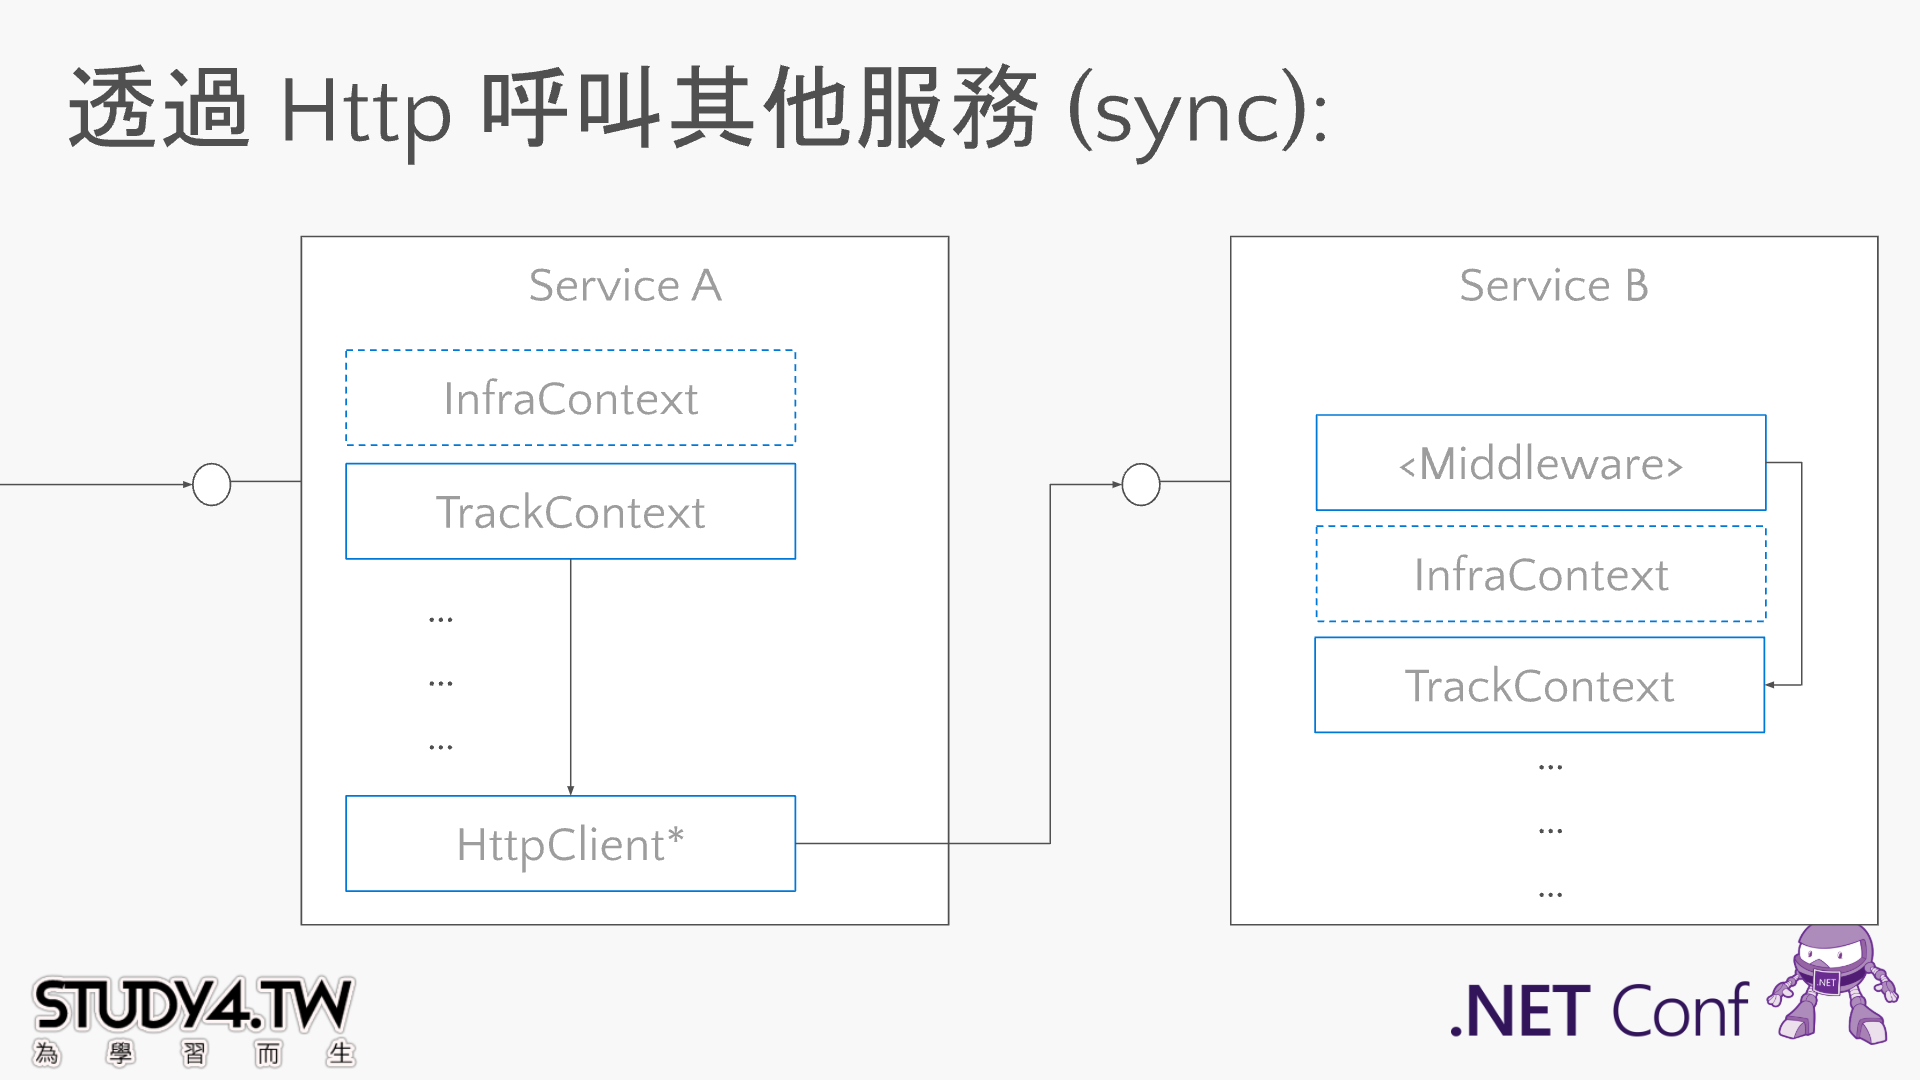
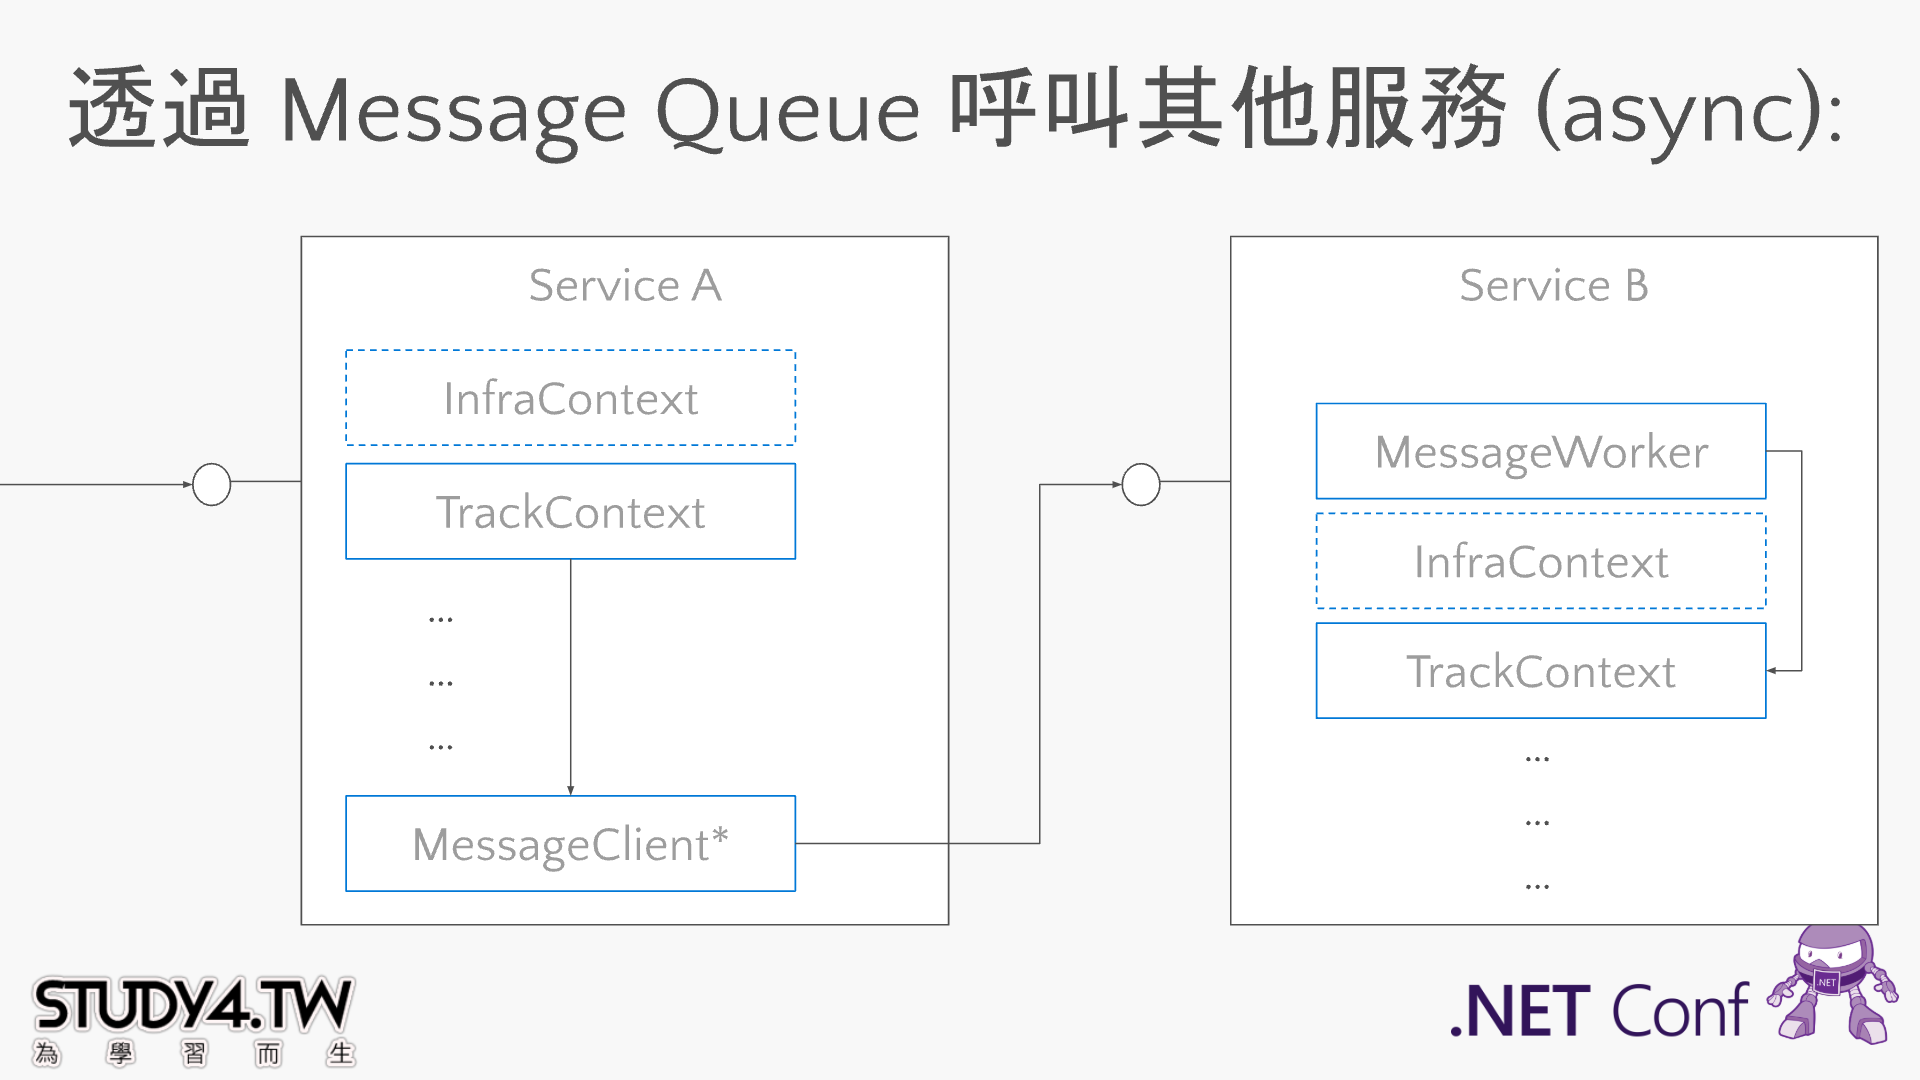
至於中間的 isolation context 是什麼? 這是中間機制的設計, 邏輯上我把 test mode / live mode “區隔” 的很清楚, 但是這 “區隔” 要如何在系統運作的體系內呈現出來? .NET 內建的 DI (Dependency Injection) framework 做了一個很好的示範, 用 Scope 層級的注入機制, 讓你的應用程式只要 Resolve Object, 就能得知在這 Scope 內的 Context, 我打算拿這個機制, 明確的界定 Scope 涵蓋範圍, 並且分別定義 Identity / Transaction Context, 來註記現在的執行身分, 以及目前進行中的交易資訊。
回顧: 我在 .NET Conf 2019 介紹的做法:
只要這個 Scope 的運作機制規劃得當, 你的系統運作就會條理分明, 所有程式碼只要按照 Context 的指示來運作就可以了. 這在複雜的系統, 或是分散式的運作體系中尤其重要, 如果 Scope 跨多個實體隔離的服務那該怎麼辦? 每個服務只要顧好自己內部的 Scope, 然後在跨服務的邊界, 明確的傳遞 Context 就可以解決問題。 這我其實在 2019 的 .NET Conf 連續講了兩堂, 就是在說明這些機制跟實作範例, 我貼兩頁簡報, 用 .NET DI 的機制, 同時用來處理 http / queue 等不同協定的 context 轉移:
Boundary Query: 這反而單純的多, 只是延續 Schema 的規範來查詢資料而已。 我的情境是: 管理後台應該要能隨時掌握 Andrew Shop 的業績數字, 這時相關功能 (主要是報表) 就必須依照 Schema 的規範, 明確的要求開發人員, 必須查詢代表 “正式交易” 範圍的數據, 而這些數據早就被規劃好要按照 Schema 明確的隔離才對, 因此這些 Query 應該要很容易才對 (如果你發現某個查詢很難下, 分不清正式與測試的資料, 別急著改 Query, 你要先回頭看看 Schema 設計的是否合理)。
4.1, 收斂需求規格
AI Generated Content
這些 code 都在我寫文章之前就先寫好了, 過程中 agent 替我保留了重要的決策過程跟程式碼, 我也在關鍵的邊界設計做好了 review, 我對 agent 的成果是有信心的; 有了這些完整的 context, 因此這段的內容我就放心交給 agent 來幫我寫了 ( code 都寫的出來了, 寫這段說明還有什麼困難的 )。
接下來, 第四章從這裡開始, 後面的部分就是 agent 主筆輸出的內容了, 我有穿插做些調整, 大約佔 20% 左右, 我就不特別標記了, 你有興趣看我讓 agent 整理的開發說明的話可以繼續往下看, 或是直接跳到第五章來看 demo 展示。
如前面所述, 我用這六個階段分別執行需求規格的收斂:
-
先確立不能違反的大原則 (當時還沒有決定實作方式)
服務部署在正式環境, 測試行為不應產生真實商業效果。
這個原則排除了兩種看似可行的方案: 先執行真實交易再退款/還原, 以及只在最後把訂單標成 test。 我特別強調這兩種做法一開始就要排除的原因, 因為從結果來看, 這兩種做法看似都能滿足要求, 但是一旦要求變嚴格 (交易正確性要求變高, 中間中斷交易的狀態都必須正確且能追溯還原時) 兩者都無法保證過程沒有影響正式業務。經驗的差距就在這些細節, 沒有留意的話這就是技術債, 而且還是你不知不覺欠下的債…
因此, 這段的規格就必須納入考量, 稍後你挑選的每種設計, 都得確實符合要求才行, 這是你要把關的第一個環節。
當時明確保留來源判定, 資料儲存與 contract, 等後續需求收斂才決定。大原則決策被 Harness 自動留下決策記錄
-
盤點領域物件, 把抽象原則轉成保護範圍。
接著盤點會持久化的物件, 區分兩種責任:
- 需要辨識正式/測試用途, 而且建立後不能任意改變用途。
- 屬於正式業務資源, 測試行為不得異動, 例如商品, SKU, 庫存, 預約與時段。
同時確認: 身分, 權限與業務檢查仍須執行, 不能看到 test 就直接成功。
這個分類也曾調整: 最初 Cart 被納入用途分類, 10/17 縮小實作範圍後, 改成 Cart 共用且不標記用途, 交易用途到 Checkout 建立時才決定。原始物件分類, 範圍修訂
-
用 Given/When/Then, 把原則展開成能觀察結果的案例。
展開明確的案例, 確保 AI 對你的需求理解是正確的。 補上成功, 正常失敗, 並行及權限的各種案例來說明。
例如:
案例 前提與操作 必須觀察到的結果 AC-001: 成功的測試交易 單價 100, 庫存 10, 測試會員買 2 件 建立 200 元的測試訂單; 庫存仍為 10; 實際略過的效果有紀錄 AC-003: 失敗的測試交易 庫存只有 1, 測試會員買 2 件 正常回報庫存不足, 不建立訂單; 不能虛構「略過扣庫存」紀錄 AC-009: 正式與測試並行 庫存 10, 正式會員買 3 件, 測試會員買 2 件 最後庫存 7; 正式統計只增加 1 筆, 300 元 這裡我另外補上兩個驗收要求: 正式統計必須比較實際結果, 不能只看 log; 只有真正走到, 且因 test 略過的操作, 才能留下略過紀錄。逐條確認紀錄
-
用邊界案例修正過度簡化的規則, 進而形成 context 模型。
我拿 PetShop 的延伸案例當例子, AC-012 與 AC-013 這兩者的對照:
- AC-012: 測試會員查詢預約商品時發現正式預約已逾期, 系統應清除預約。
- AC-013: 系統接手處理測試訂單, 後續事件與重試仍須遵守測試限制。
這案例很有趣, 原始規格的定義是查詢預約商品時, 可以將前面的消費者已經逾期沒有結帳成功的預約標記為
Expired, 但是這次是測試查詢, 另一條規則 “測試交易不得影響真實業務行為”, 我曾經把這規則解讀成 “測試交易不得異動預約或庫存資訊”… 所以 agent 就問我這規格衝突該怎麼辦? 測試交易到底該不該把逾期的預約重新標記為Expired?跟前面測試交易不該變更庫存的案例正好相反, 這邊我認為測試案例應該要刪除過期的預約, WHY? 這題花了我十分鐘來思考, 最後我的答案是, AC-012 描述的情境, 我應該解讀成:
- 查詢預約商品 (不管正式或是測試身分) 會觸發檢查的要求
- 系統收到檢查要求, 會依據到期規則將逾期預約標記為
Expired, 並保留預約與 Product 記錄
我判定: AC-012 是個 “跨越兩個邊界” 的行為…
這案例中間隔著 “事件驅動” 的機制, 把觸發跟執行分成兩半, 這就是個天然的系統運作邊界, 這裡要區分的是查詢與系統到期整理的業務責任, 兩者只是被事件驅動綁在一起執行而已 (甚至初期的實作簡化成同一段 code)。 AC-012 的查詢只是發現正式預約已經逾期, 系統依據正式資料與時間規則執行到期整理; AC-013 則是繼續處理測試訂單, 後續事件仍須保留測試用途。 判斷的關鍵是工作本身的目的, 以及它正在處理的交易, 不能因為跨過事件邊界就解除測試限制。 因此想通這定義後, 結果就很明確了, 這案例應該要正常更新逾期預約的狀態才對。
因此, AC-012 原草案曾把到期更新也當成測試寫入而略過, 我在這邊則明確要求修正。這案例的結果很重要, 我都還沒決定實作做法, 很慶幸我有 review 這段, 而 agent 也確實的把這衝突挖出來讓我確認, 我才有機會確實的思考這些問題並給出正確的 AC, 這結果跟思考過程都被忠實記錄下來, 成為 Ac-012 + 背後的 decisions 決策記錄。
這組案例顯示, 不能只靠最初呼叫者的 test 標記決定全部後續行為。到期整理的修正紀錄
我進一步把判斷依據分成:
- Identity context: 誰正在執行。
- Transaction context: 正在處理哪一筆交易, 以及它的用途。
架構負責正確傳遞或恢復資訊, 業務操作負責依資訊執行政策。兩類 context 的決策
-
收斂 PoC 範圍, 再轉成正式規格, 合約與測試。
10/17 確認標準商店優先, 暫不實作 PetShop Test Mode; 測試付款以 PaymentId 白名單代表, 並在 Checkout 建立時固定用途。
接著 agent 把 AC 對應到 正式測試案例, 例如 AC-002 展開為正式會員使用測試 PaymentId, 會員用途不變, 交易用途固定等案例。AC 與正式 testcase 對照
這裡我也要求 agent 走一次 TDD 的紅綠循環: 白名單與 Context 的 21 項新增測試, 先確認可編譯但測試失敗, 再以相同行為斷言驗證實作轉綠。這次針對的是特定基礎合約, 並未在一開始就寫好所有 AC 的完整測試。TDD 檢查點
-
Phase 2 之後重新確認隔離要求, 追加 Phase 3。
10/19 的重要決策是: 嚴格隔離交易, 認證與非交易資料共用; 既有交易依保存用途決定 storage 與效果, 不能只依照當下 Token 重新分類。
同時修訂商品改價政策: test identity 必須明確被拒絕, 不能回報成功但略過寫入。這直接修改了 AC-005, 並新增儲存隔離規格與 26 條案例。交易邊界決策, 追加 Phase 3 的決策
因此, 拆 collection 與商品改價明確拒絕, 是我在後續需求收斂時才確定的設計。
以上這些, 實際過程採取的是迭代式開發 … 實際上我是修訂了幾個 AC 定義, 然後就真的讓 agent 完成部分的開發, 並且局部驗證 AC 是否通過, 然後再繼續修訂其他 AC (甚至有回頭修正已經完成開發的部分), 直到全部完成為止。 上面這些, 是我最後在寫這篇文章時重新回頭整理的原則, 同時把最終定案的這些 AC 列出來給各位參考, 看完你會比較有感上面這些決策到底在決定什麼:
完整 AC 清單如下, 採用最新確認版本:
-
AC-001 (標準商店)
測試會員可完成一般商品結帳; 正常計算與驗證, 不影響庫存, 真實付款, 出貨及正式統計; 略過效果可追查。 -
AC-002 (標準商店)
正式會員使用測試 PaymentId, 可成立測試交易; 會員/Token 仍為正式用途。 -
AC-003 (標準商店)
測試交易庫存不足時正常失敗, 不建立訂單, 不產生虛構的略過紀錄。 -
AC-004 (標準商店)
Member, Token, Checkout, Order 建立後, 正式/測試用途不能互轉; 其他合法欄位仍可更新。 -
AC-005 (標準商店; P3 修訂)
test identity 修改商品售價必須明確拒絕; 商品與後續正式交易的價格不變。 -
AC-006 (標準商店)
測試修改 SKU, 必要檢查照常; 通過後略過更新並留紀錄, SKU, 關聯與庫存不變。 -
AC-007 (PetShop, 未納入)
測試預約通過檢查後, 不建立 Reservation, 衍生商品或占用正式時段。 -
AC-008 (PetShop, 未納入)
測試預約遇到已占用時段, 正常拒絕, 既有正式預約不受影響。 -
AC-009 (標準商店)
正式與測試交易並行, 兩者用途與效果各自隔離, 只有正式交易影響正式業務。 -
AC-010 (標準商店)
測試會員的購物車增刪正常保存; Cart 不標記用途, 不因 test 身分略過寫入。 -
AC-011 (標準商店)
測試會員不能完成其他會員的 Checkout, 即使雙方都是 test。 -
AC-012 (PetShop, 未納入)
測試查詢發現正式預約逾期, 可通知系統正常清理; 不因發現者為 test 而停止整理。 -
AC-013 (標準商店)
測試訂單的事件, 背景處理與重試維持測試用途, 不因改由 System 處理而解除限制。 -
AC-014 (標準商店)
用途必須明確; 遺失或矛盾視為 BUG, 阻止效果, 不默認成正式交易。 -
AC-015 (PetShop, 未納入)
測試預約略過建立後, 流程停止; 不捏造預約商品接續購物車與結帳。
4.2, 承接設計架構
前面說到, 實際上我是 4.1 / 4.2 穿插著執行的, 只是寫文章的時候我是分開整理, 各位比較能理解我思考的脈絡跟實作的方式區隔。 雖說要決定架構實作的方式, 但是 agent 在 coding 時, 我完全沒有介入 coding 的過程, 我只有挑出關鍵的 interface / contract 用肉眼 review 之後 (很少, 後面我會列出來), 直接要求接下來的實作不准變更 interface, 然後就是確認結果能否符合預期 AC 的描述了。 這是我不逐行 review 全部實作, 卻仍能掌控開發品質的做法, 同時兼顧架構設計以及執行結果, 完成後就可以 commit / push 了
在 4.1 的這六個步驟, 我最在意下列這三個環節, 因此我全程真正有 “看 code” 的只有這幾個地方, 確保實作出來的結果跟我想要的是一致的:
-
需要被標記
".IsTest"的資料庫物件 Schema 確認 這部份的設計, 決定了 database schema 的規劃, 儲存的結構都在這裡確認 -
需要被定義的
Identity/Transaction Context以及運作方式的確認 這邊的設計主要是結合了 .NET Dependency Injection 機制的對應, 我在 Scope 內注入能描述當下 identity / transaction 的資訊, 所有程式碼都能直接取得; 跨 scope 就要明確傳遞, 這可以解決 async / offline 執行等等邊界問題 -
查詢 “真實商業效果” 的 query 我先定義了哪些是我認定的 “真實商業效果”, 某種程度也是拿來當作驗證結果用的設計 實際系統應該是各種統計報表的功能, 在這邊我只簡單定義了一組 admin api / admin cli 來簡化, 這 cli 可以查詢業績統計, 會按照 (1) 的設計排除 test mode 的資訊
4.2.1, Schema Design
目前有四種物件保存 .IsTest:
| 物件 | 用途如何決定 | 儲存位置 |
|---|---|---|
Member |
建立時依會員名稱白名單決定 | 共用 members |
MemberAccessTokenRecord |
簽發時繼承 Member 的用途 | 共用 member_tokens |
CheckoutTransactionRecord |
建立時依 Member 與 PaymentId 決定 | 正式/測試各自的 active, archived collections |
Order |
繼承建立它的 Checkout 用途 | orders/test_orders |
這四種物件的 Schema 如下:
public class Member
{
    public int Id { get; set; }
    public bool IsTest { get; init; }
    // ...
}

public class MemberAccessTokenRecord
{
    public string Token { get; set; } = string.Empty;
    public int MemberId { get; set; }
    public bool IsTest { get; init; }
    // ...
}

public class CheckoutTransactionRecord
{
    public int TransactionId { get; set; }
    public int MemberId { get; set; }

    public bool IsTest { get; init; }
    public int PaymentId { get; init; }
    // ...
}

public class Order
{
    public int Id { get; private set; }
    public bool IsTest { get; init; }

    public int? CheckoutTransactionId { get; init; }
    // ...
}
來源: 會員用途欄位, Token 與 Checkout 的儲存結構, 訂單用途欄位。
這段值得說明的重點是: 身分用途與交易用途分別保存, 因此正式會員也能建立測試交易。 Cart, Product, SKU, Inventory 則維持共用, 沒有增加 .IsTest。
用途的決定與承接, 對應到以下兩段程式碼:
// Checkout 建立時, 決定並保存這筆交易的用途。
var transaction = new CheckoutTransactionRecord
{
    // ...
    PaymentId = command.PaymentId,
    IsTest = member.IsTest || _allowlist.IsTestPayment(command.PaymentId),
    // ...
};

// Order 承接 Checkout 已經保存的用途。
var order = new Order(_transactions.NextOrderId())
{
    Buyer = consumer,
    IsTest = transaction.IsTest,
    CheckoutTransactionId = transaction.TransactionId,
    // ...
};
來源: Checkout 建立, Order 建立。
目前 PaymentId 是用來查白名單的識別值, 沒有獨立的 Payment.IsTest 物件。交易建立後, 後續流程沿用保存的用途, 不重新依白名單判定。
Phase 3 將這個用途直接對應到 collection:
public static string Orders(bool isTest) =>
    isTest ? "test_orders" : "orders";

public static string Checkouts(bool isTest, bool archived = false) =>
    (isTest ? "test_" : "")
    + (archived
        ? "archived_checkout_transactions"
        : "checkout_transactions");
來源: 交易資料的分區路由。
init 表達建立後不可任意賦值的意圖; 持久化層另外檢查用途與 collection, Checkout/Order 關聯的一致性, 不能只靠 init 保證資料隔離。
4.2.2, Scope Design
我確認的兩個 Context 介面如下:
public interface IIdentityContext
{
    IdentitySnapshot Current { get; }
}

public interface ITransactionContext
{
    TransactionSnapshot? Current { get; }
}
兩份快照分別保存:
public sealed class IdentitySnapshot
{
    public IdentityKind Kind { get; }
    public int? MemberId { get; }
    public bool IsTest { get; }

    // ...建構式與 factory
}

public sealed class TransactionSnapshot
{
    public TransactionKind Kind { get; }
    public int Id { get; }
    public bool IsTest { get; }

    // ...建構式
}
其中 IdentityKind 為 Anonymous, Member, System; TransactionKind 為 Checkout, Order。
來源: 身分 Context 合約, 交易 Context 合約。
這兩個 Context 分別回答不同的問題:
Identity Context 回答「現在是誰在執行」, Transaction Context 回答「現在處理的是哪一筆交易」。兩者的用途不必相同: 正式會員可以建立測試交易, 正式的 System 身分也可以處理測試訂單。是否扣庫存等交易效果, 必須依交易用途判斷, 不能只看執行者是不是測試帳號。
在實作上, 兩種 Context 分開註冊為 scoped service, 同一個 scope 內透過介面與具體類別取得的是同一份物件:
services.AddScoped<IdentityContext>();
services.AddScoped<IIdentityContext>(
    sp => sp.GetRequiredService<IdentityContext>());

services.AddScoped<TransactionContext>();
services.AddScoped<ITransactionContext>(
    sp => sp.GetRequiredService<TransactionContext>());
來源: Context 的相依性注入設定。
HTTP 入口驗證 Token 後建立 Identity; 涉及既有 Checkout 時, 另外檢查買方, 再從保存的 Checkout 載入 Transaction Context。Context 並不是跨 HTTP request 自動延續, 而是在新的執行邊界重新建立。
訂單事件的這段最能說明這個設計:
using var scope = scopeFactory.CreateScope();
var services = scope.ServiceProvider;

// ...初始化操作結果與錯誤處理

services.GetRequiredService<IdentityContext>()
    .Initialize(IdentitySnapshot.System);

services.GetRequiredService<OrderContextLoader>()
    .Bind(orderId);

// ...執行事件處理器
OrderContextLoader.Bind(orderId) 會讀取已保存的 Order, 再用它的 IsTest 建立交易快照。因此, 即使原來的 HTTP request 已經結束, 新的 System scope 仍然知道這是一筆測試訂單。載入實作
後續政策分成兩種:
- 商品改價: 檢查 Identity, 測試身分明確拒絕。
- Checkout 扣庫存, Order 衍生效果: 檢查 Transaction, 測試交易略過受保護寫入; 缺少正確的交易 Context 則視為錯誤。
對應程式集中在 受保護寫入的執行邏輯。
4.2.3, Query Design
這裡我用「訂單統計」與「庫存讀回」兩組結果, 確認測試訂單沒有混入正式統計, 也沒有扣掉共用庫存。
訂單查核的實際入口是 AdminQueryService.GetOrders():
public AdminOrderResult GetOrders(AdminQueryOptions options) => Read(() =>
{
    var queriedAt = timeProvider.GetUtcNow().UtcDateTime;

    var candidates = new TransactionStore(database.Database)
        .ReadOrders(options.Purpose)
        .Select(OrderRow)
        .Where(x => MatchesPurpose(x.IsTest, options)
                 && MatchesMember(x.MemberId, options))
        .ToArray();

    var excluded = candidates.Count(
        x => HasTimeFilter(options) && x.CreatedAt == null);

    var rows = candidates
        .Where(x => MatchesTime(x.CreatedAt, options))
        .OrderByDescending(x => x.Id)
        .ToArray();

    var unknown = rows.Count(x => x.TotalPrice == null);

    decimal known;
    try { known = rows.Sum(x => x.TotalPrice ?? 0m); }
    catch (OverflowException)
    {
        throw new AdminDataInvalidException("訂單金額超過可表示範圍。");
    }

    return new AdminOrderResult(
        Page(rows, options, queriedAt, excluded),
        unknown == 0 ? known : null,
        known,
        unknown);
});
來源: 管理查詢與統計的實作。
這段查詢有三個要求:
- 預設
Purpose = "normal"; 先選擇用途對應的 collection, 再核對 Order 自己的IsTest, 不依 Buyer 的用途分類。 - 先算完整符合條件的統計, 再分頁, 總額不受畫面顯示幾筆影響。
- 歷史訂單若缺少金額, 回傳未知筆數, 完整總額為
null; 不把未知金額當作零元訂單。
管理 CLI 對應的查詢如下, 假設已完成 publish 並設定 Admin 認證:
# 正式訂單統計
.local/admin-cli/publish/shop-admin stats --source order --type normal

# 測試訂單統計
.local/admin-cli/publish/shop-admin stats --source order --type test

# 合併查核正式與測試訂單
.local/admin-cli/publish/shop-admin stats --source order --type all
來源: AdminCLI 操作說明。這裡統計的是保存的訂單金額; 專案沒有接真實金流, 不能將它描述成已收款金額。
庫存則有直接讀回資料庫的驗收程式碼。案例預先建立庫存 10 件, 購買 2 件, 完成 Checkout 後檢查:
Assert.Equal(CheckoutCompleteStatus.Succeeded, result.Status);

Assert.Equal(
    expectedTest ? 10 : 8,
    Context.InventoryRecords.FindById(sku).AvailableQuantity);
同一案例涵蓋四種組合:
[InlineData(false, 0, false)]
[InlineData(false, 990001, true)]
[InlineData(true, 0, true)]
[InlineData(true, 990001, true)]
參數依序為 memberTest, payment, expectedTest。只有「正式會員+一般付款」會把庫存從 10 扣到 8, 其餘組合仍為 10。
來源: 交易用途與儲存隔離的驗證。
商品改價也有相同的讀回檢查: 測試身分要求將價格從 100 改成 80, 操作必須拒絕, 保存價格仍為 100:
Assert.Throws<TestIdentityForbiddenException>(
    () => maintenance.UpdatePrice(id, 80, _ => { }));

Assert.Empty(effects.Skipped);
Assert.Equal(100, Context.Products.FindById(id).Price);
來源: 商品改價驗收。
這裡的驗收重點是: 驗收會讀回實際庫存, 商品價格與訂單統計, 確認隔離結果; log 則用來交代哪些操作被略過。
5, 實際驗證
前面講的都是設計跟實作, 這個段落我就拿實際的成果來驗證前面我自己開的需求規格吧。 礙於篇幅, 我就不跑完所有的測試案例了, 我只跑我要示範的主要路徑: 先完成一筆測試交易, 然後再完成一筆正式交易, 然後看畫面輸出 (含 log) 及資料庫輸出結果。
這段我想同時展示幾個環節:
- 這篇文章的主軸, Test Mode 實際運作的效果
- 我把完整的 Context 都交給 Agent 了, 下列的 demo, 擷圖操作, 展示過程的撰寫與說明都由 agent 處理
在我的設計, 消費者操作購物車進行購物, 這是一般通稱的 “前台”, 比較正式的說法是 Storefront, 而管理者看的是 “後台”, 或是 Admin Console / Dashboard 等稱呼, 在這邊我有準備 Storefront 的網站可以直接操作展示, 為了最大化的讓 agent 容易操作, 之前我提過一個概念, 就是善用無障礙的設計, 因此這 ux 我就直接沿用無障礙的規範來進行… 底下的 demo 我是透過 computer use 自動操作, 並且擷圖記錄下來, 讓 agent 替我補完 demo 的過程說明
而管理查核的部分, 我只有開發 admin api, 以及對應的 admin query (CLI), 後面的 demo 就讓 agent 用 CLI 查詢訂單與金額統計, 並整理查核結果。
AI Generated Content
這章節從這裡開始, 後面的部分就是 agent 輸出的內容了, 同樣你有興趣看 demo 過程的話可以繼續往下看, 或是跳到第六章直接看文章的結論。
以下是 2026-10-24 在本機 PoC 的實際操作結果。這次使用獨立的 demo 資料庫, 按照「先測試, 後正式」的順序完成兩筆交易, 並在操作前與每次結帳後讀回庫存與訂單統計。當時使用的程式碼版本為
c67e2d3; 執行記錄與原始證據也一併保留。
5.1, 主軸情境
我想確認, 這間商店能不能讓我安全地走完一次購物流程。我會先用測試付款完成交易, 查看訂單與資料變化, 再用一般付款重新買一次, 確認兩者的業務效果確實不同。
情境就用我自己的帳號 andrew, 在同一間 Andrew Shop 買三罐啤酒。這個帳號是一般會員, 商品, 價格與優惠也都沿用商店原本的資料。兩次操作之間, 我會保持相同的帳號, 商品與數量, 只在建立新交易時換一個 PaymentID。
這樣安排, 就能看到前面設計的一個重要結果: 一般會員也能建立測試交易, 交易的用途跟會員的用途是分開的。 測試交易應該照常計算價格與折扣, 通過業務檢查後留下訂單, 讓我有結果可以查看; 測試用途則決定這筆交易能不能扣庫存, 以及它是否會計入正式訂單的統計。
這也呼應了文章一開始提到的 Agent 使用情境。當我希望 Agent 練習操作這間商店時, 它需要讀到有意義的商品與優惠資訊, 也需要能夠走完流程, 理解操作結果。這次先透過網頁操作, 把這種測試體驗具體展示出來。
這個 PoC 的 PaymentID 是用來識別付款用途的模擬值, 尚未串接真實金流。所以下面觀察的是訂單, 庫存與訂單金額統計的變化, 金額都指保存的訂單金額。
5.2, 實際展示
開始操作前, 我先記錄啤酒的可用庫存, 以及正式, 測試訂單各自的筆數與總額。接下來只執行這兩筆交易, 每完成一筆就讀回一次資料, 這樣才能把每次變化對應到剛才的操作。
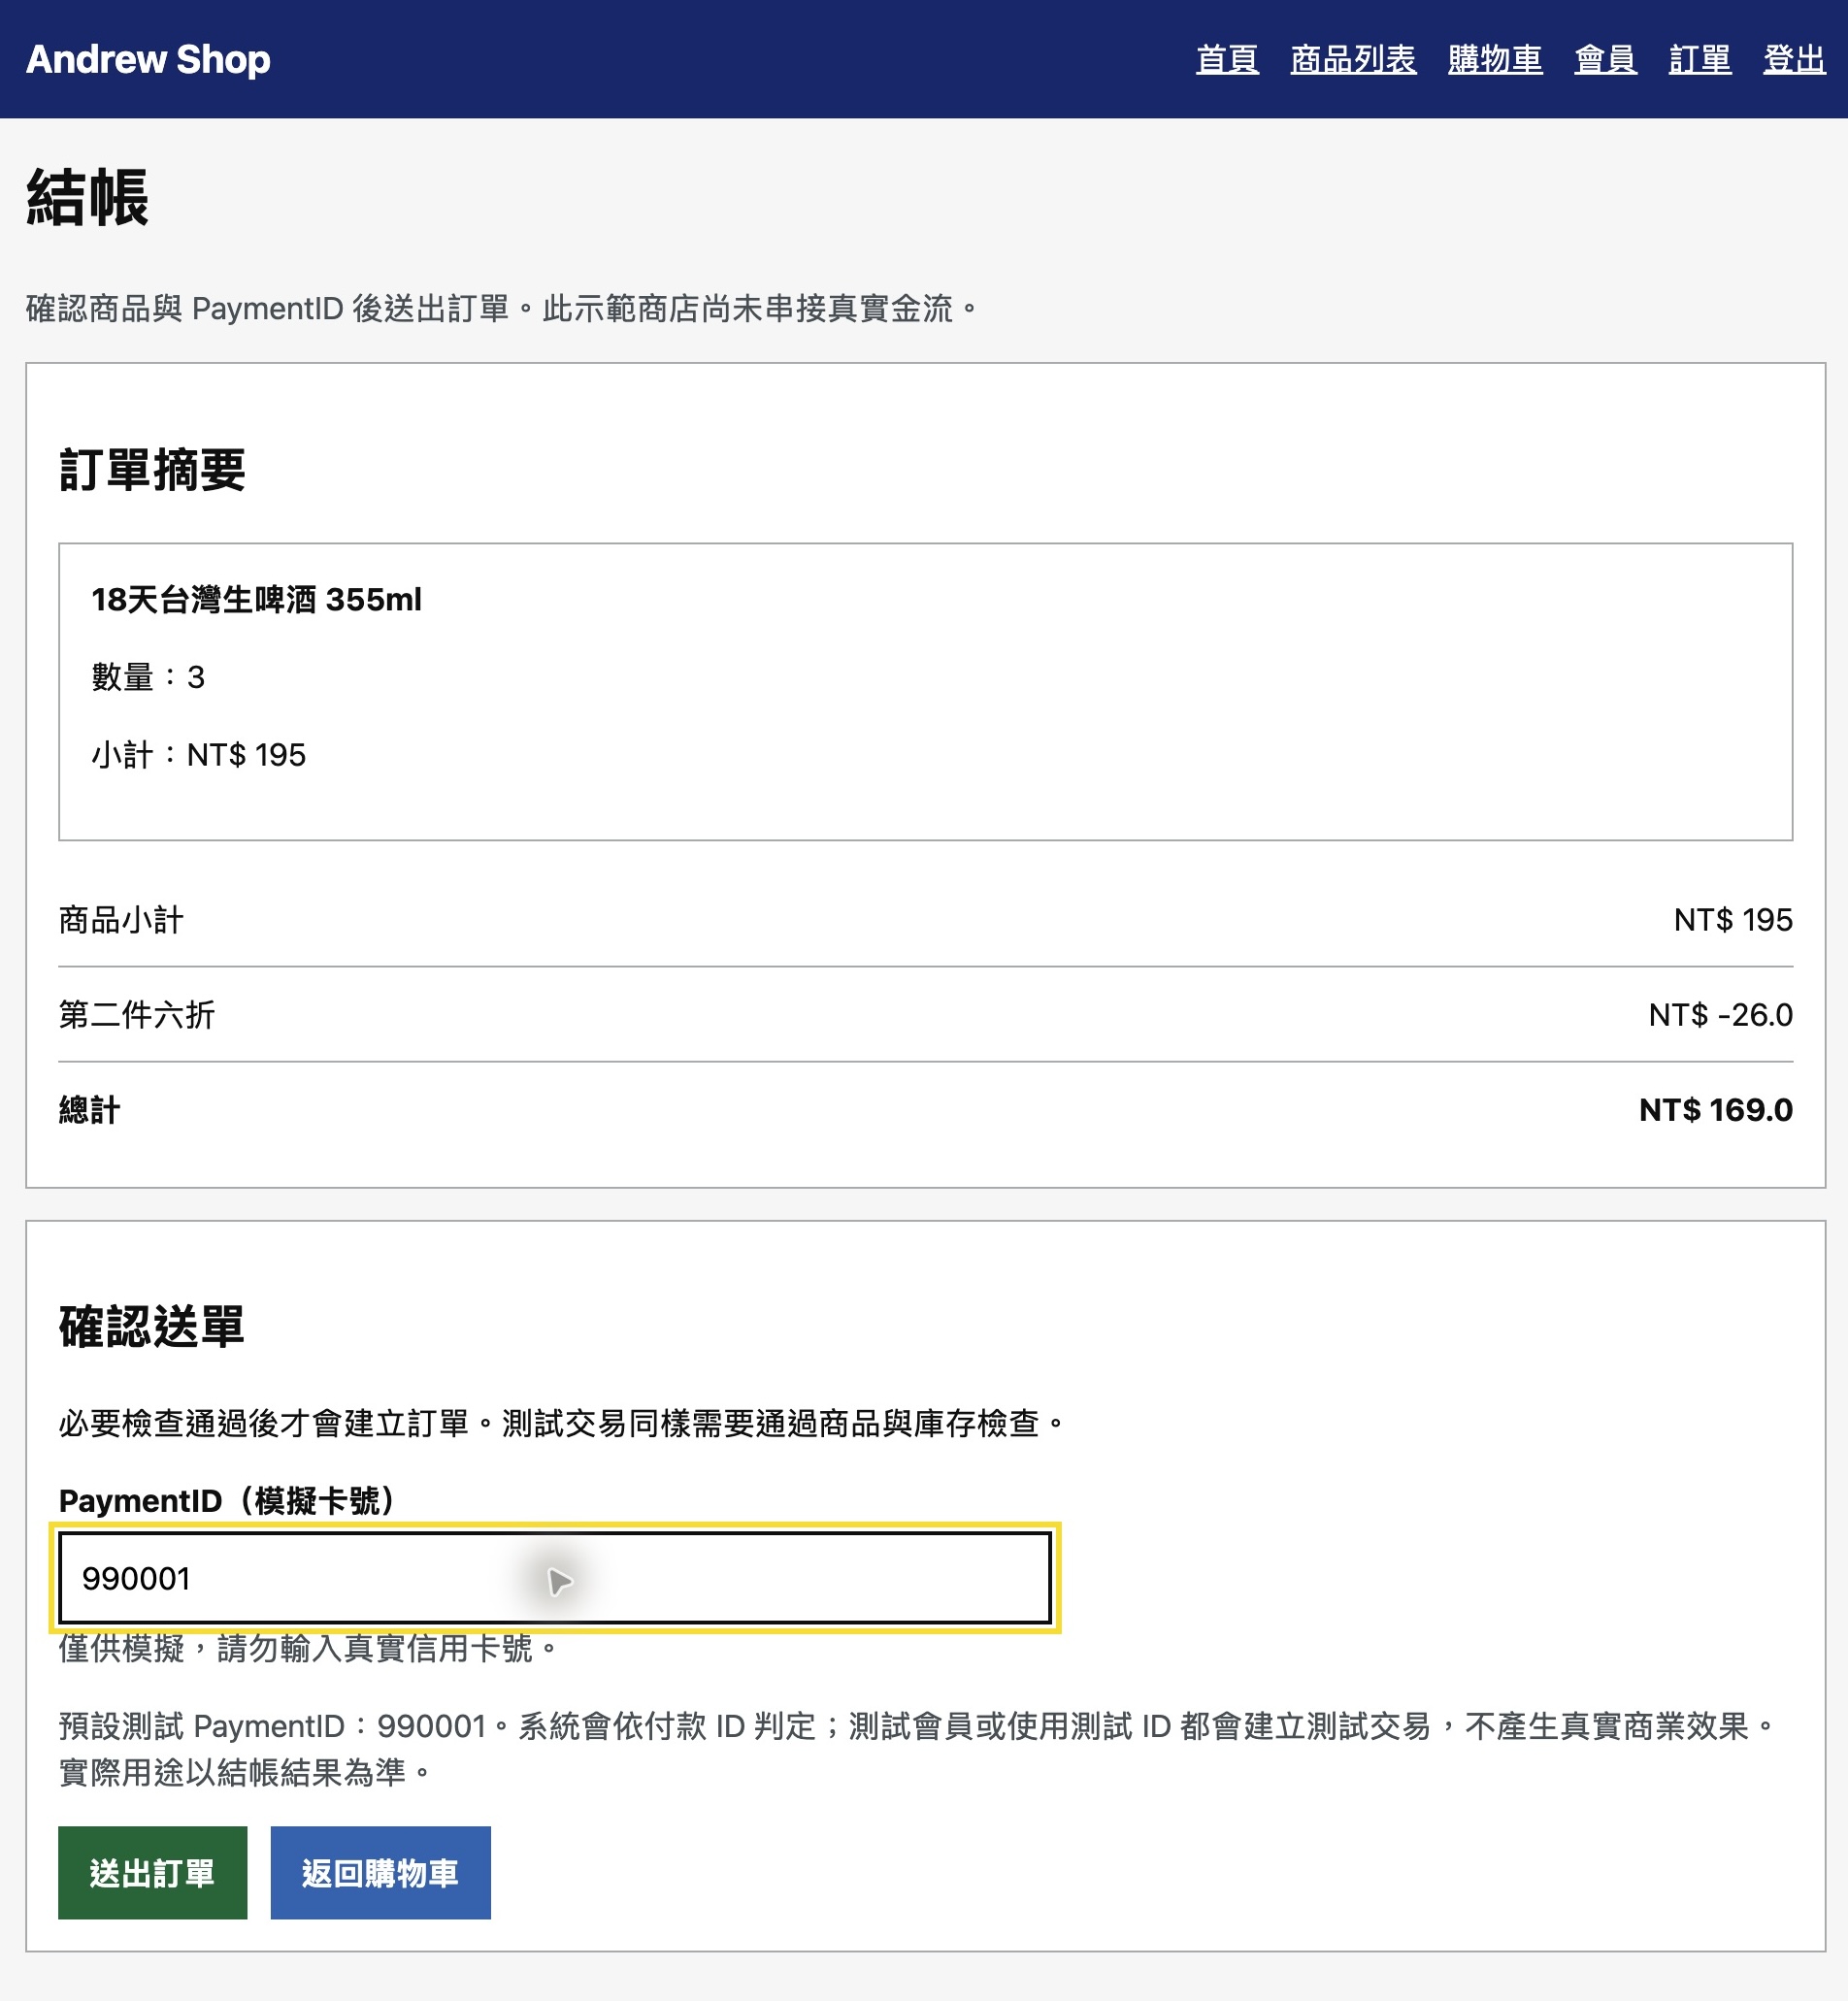
這次選的商品是三罐啤酒: 單價 65 元, 小計 195 元, 套用第二件六折後折抵 26 元, 訂單總額是 169 元。兩次購買都用相同的商品與優惠條件, 方便直接比較。
第一步, 先完成測試交易。
我先把三罐啤酒加入購物車, 在結帳頁填入測試 PaymentID 990001, 然後送出訂單。依照前面定義的規則, 雖然我是一般會員, 這次建立的 Checkout 與後續 Order 都應該是測試用途。
結帳成功後, 畫面讓我確認了三件事: 這是一筆 test 交易, 執行結果是 succeeded, 以及這次因測試用途略過了庫存扣減 inventory.deduct。這次建立的是測試訂單 #1, 訂單明細仍然列出三罐啤酒, 26 元的折扣, 以及 169 元的總額。
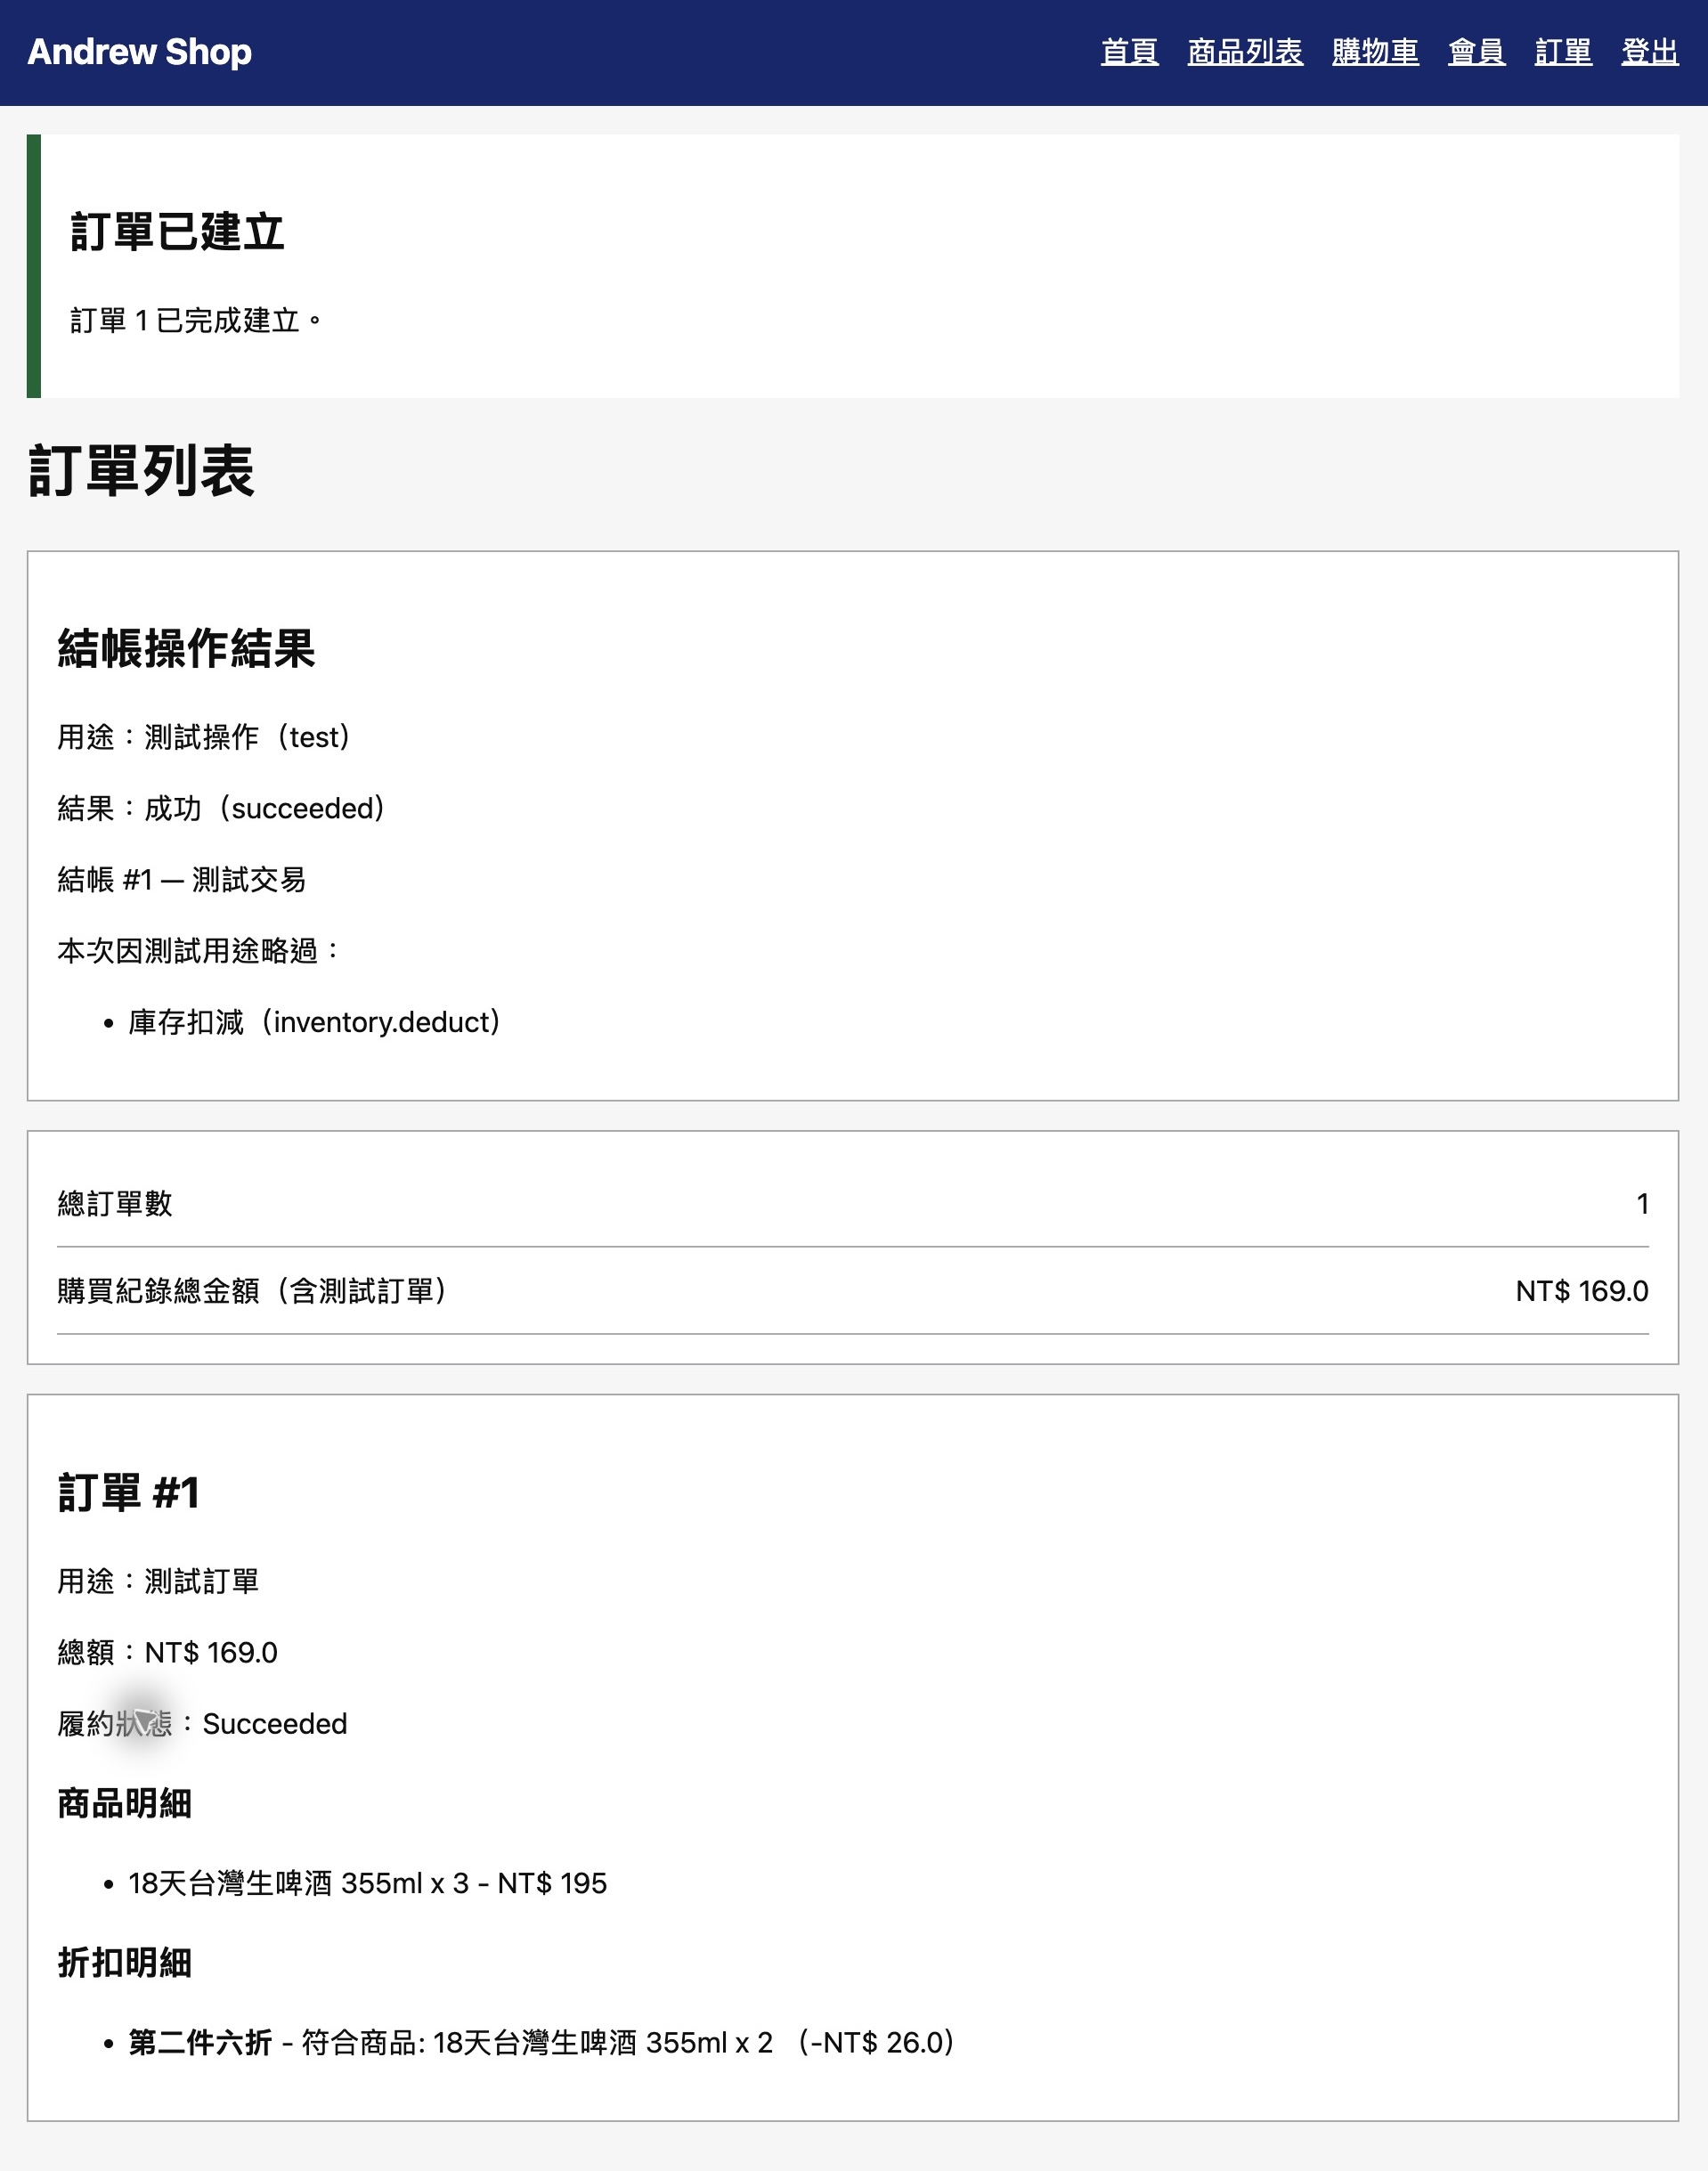
接著就要查資料了。畫面說有略過, 我再確認實際保存的結果: 測試訂單增加一筆, 測試訂單總額增加 169 元, 但啤酒庫存仍是 100, 正式訂單總額仍是 0 元。這才對得上前面要求的「不產生真實商業效果」, 也讓這次測試留下可以追查的結果。
第二步, 以一筆新的正式交易對照。
接下來, 我用同一個帳號, 重新把三罐啤酒加入購物車, 這次填入一般 PaymentID 123456。上一筆測試訂單繼續保留原用途, 這次會建立新的 Checkout 與 Order。
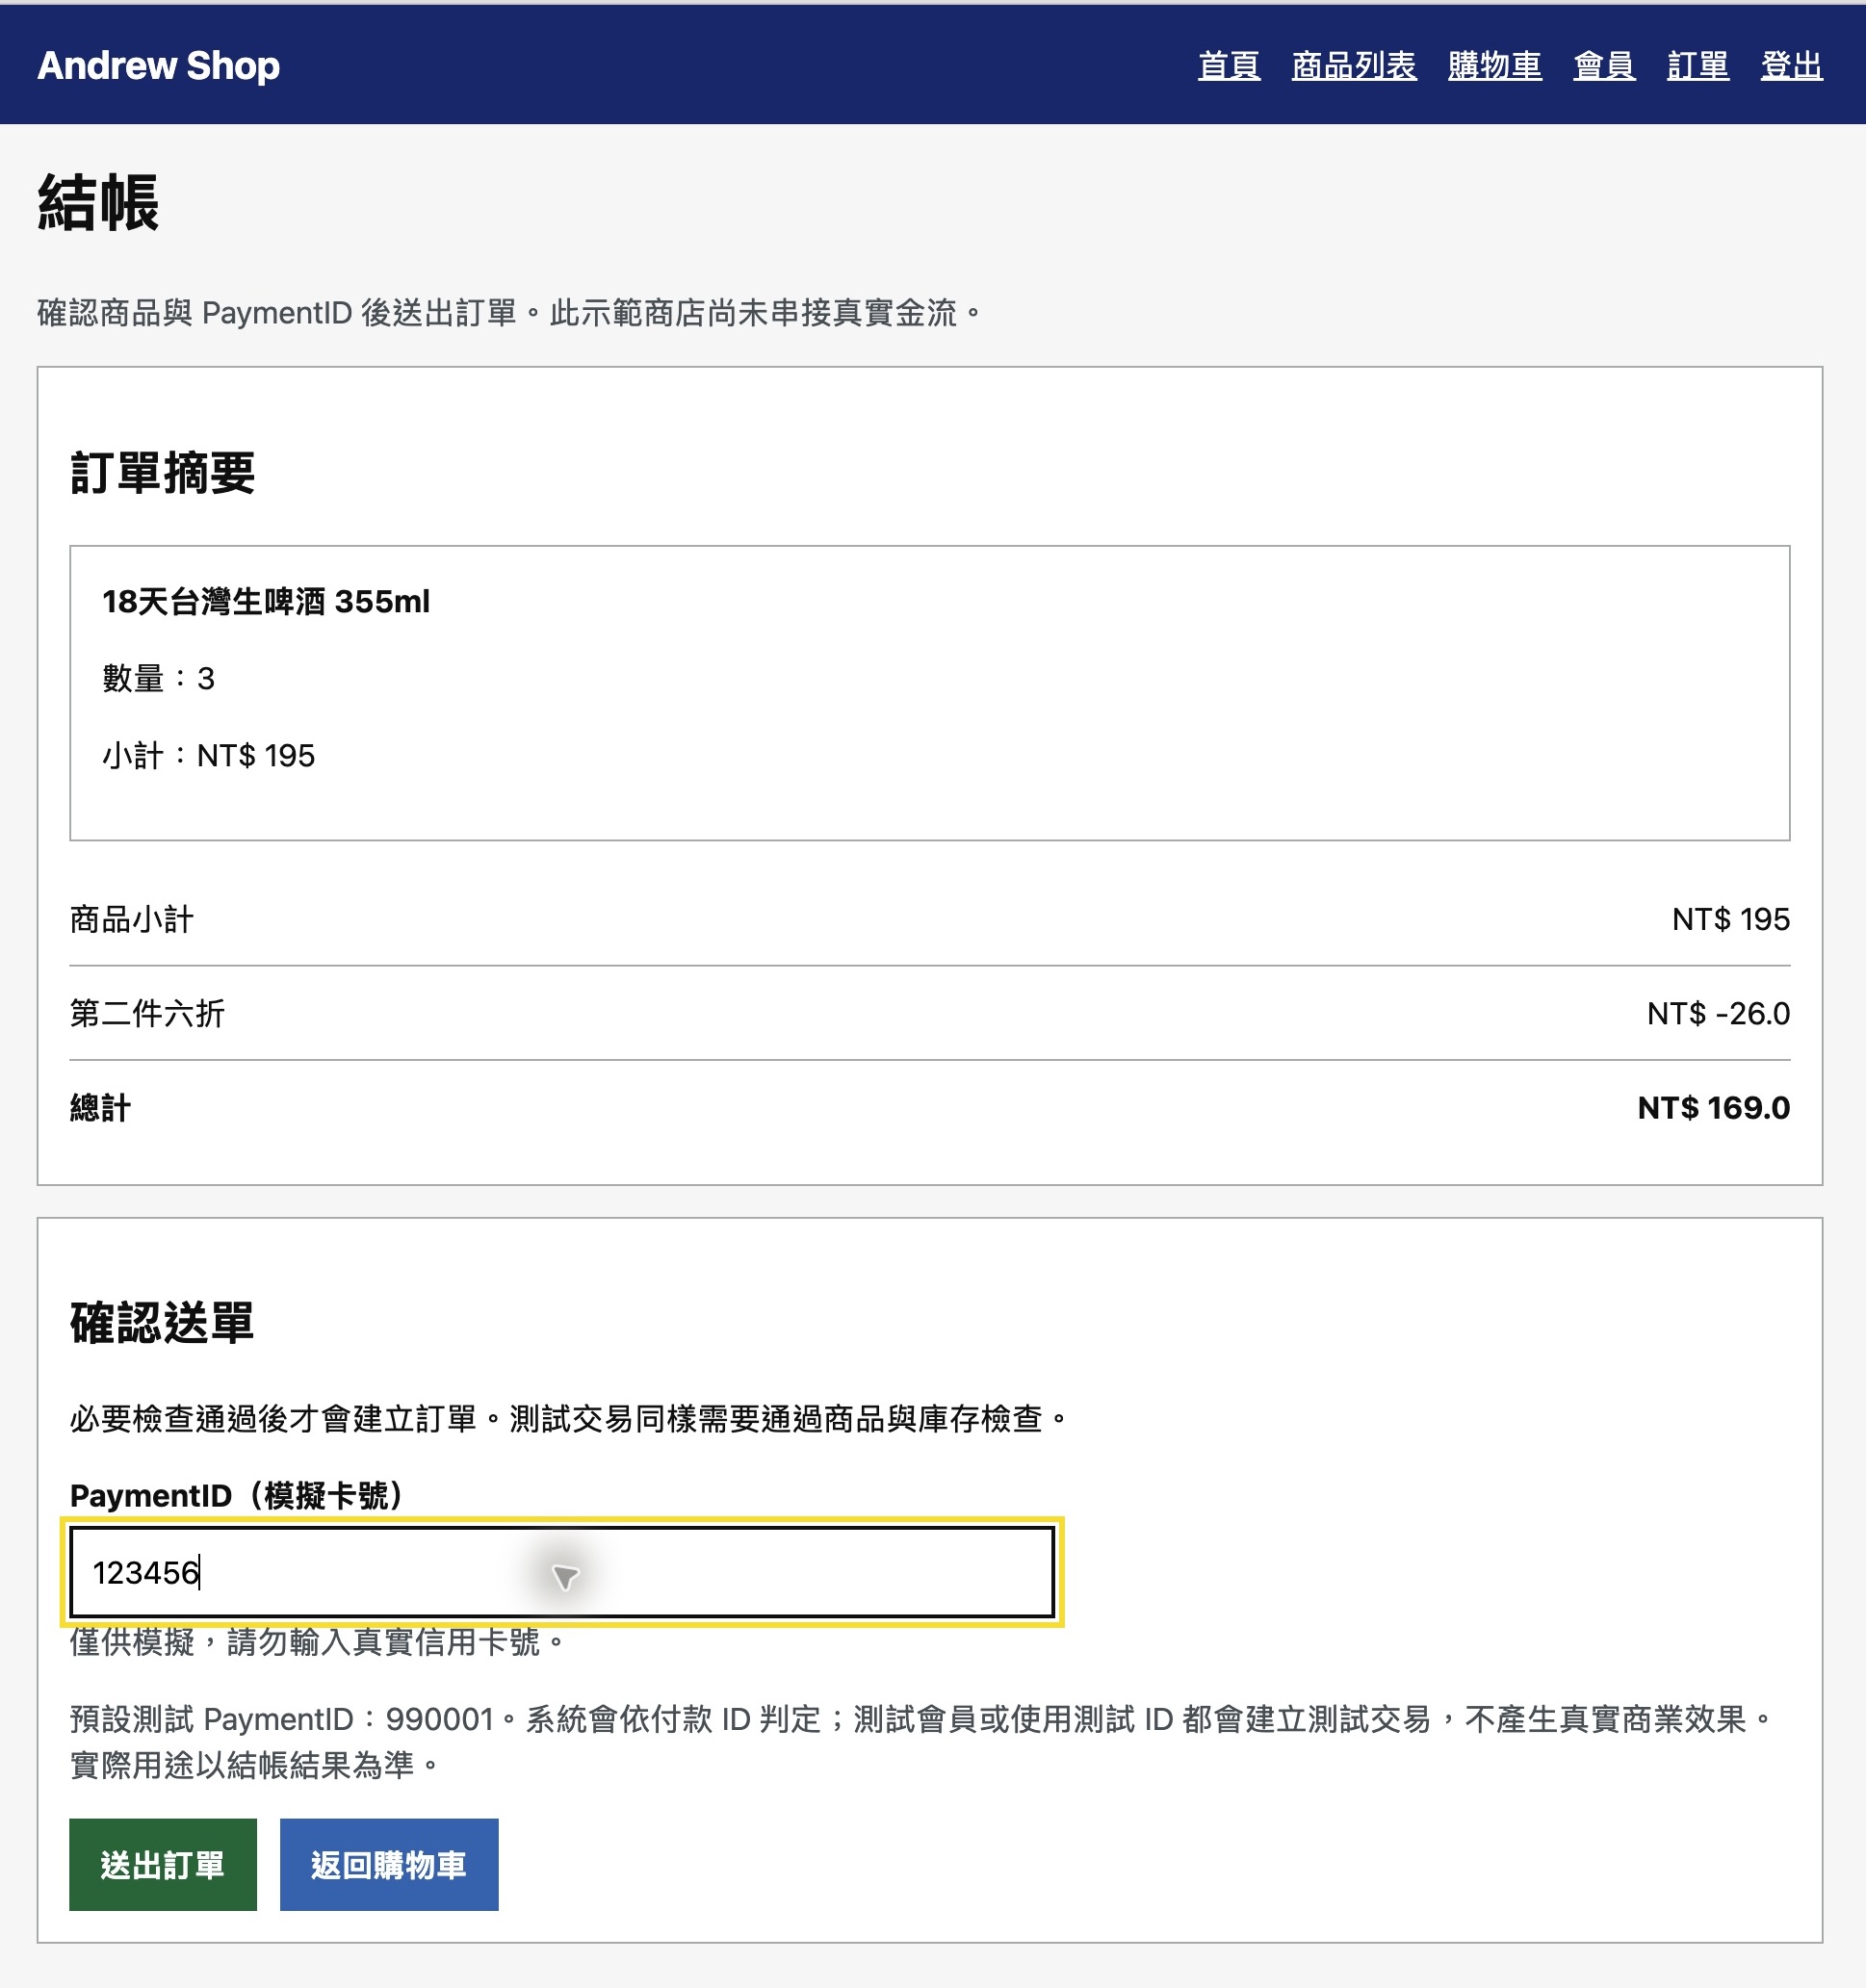
在相同價格與優惠條件下, 這筆正式訂單 #2 的總額同樣是 169 元。結帳畫面顯示 normal, succeeded, 沒有因測試而略過的步驟。這次讀回資料, 可以看到庫存減少三罐, 從 100 變成 97; 正式訂單增加一筆, 總額增加 169 元, 先前的測試訂單與其統計則維持不變。
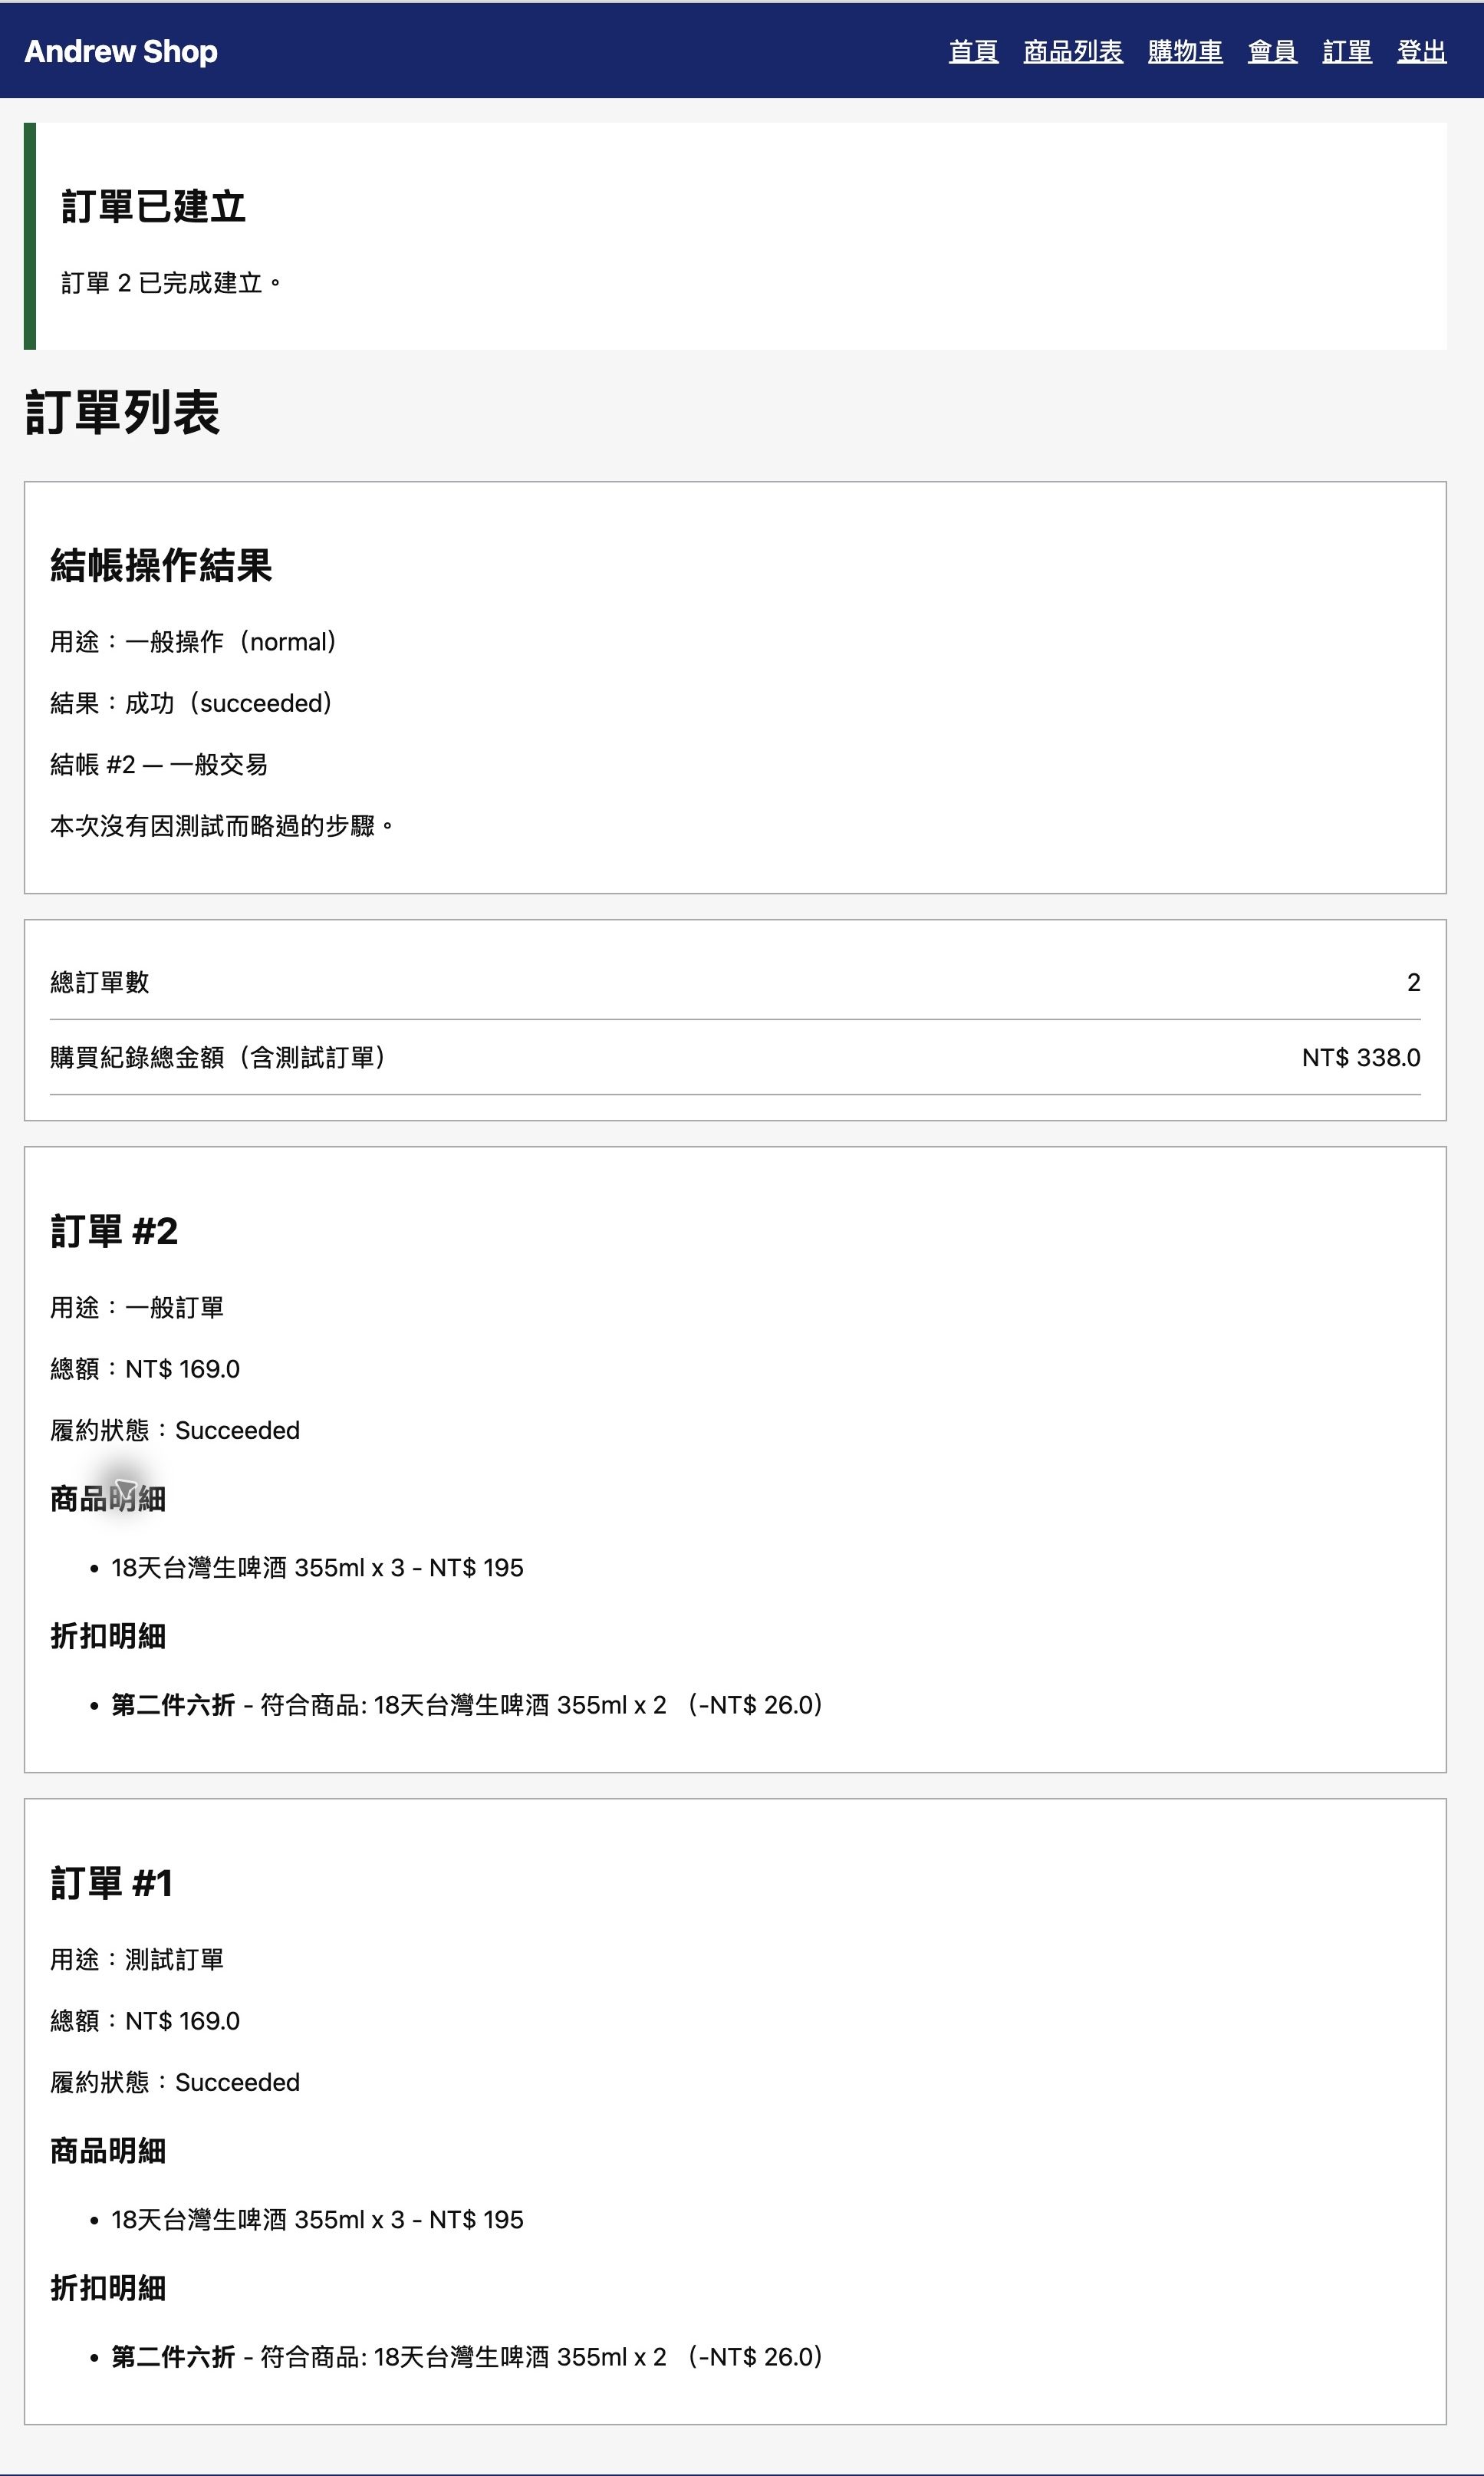
最後, 把兩次操作的結果放在一起看。
兩筆交易完成後, 我再用前面介紹過的 shop-admin 管理查詢 CLI, 確認保存的訂單與統計結果。以下是對本輪 demo 保留的資料執行查詢所得到的原始輸出; CLI 已設定連向這次 demo 的 API, 並使用對應的管理查詢憑證。這裡的 all 是特別開發的管理查核功能, 由 API 明確讀取正式與測試兩個分區, 再彙整結果, 原有資料仍分開保存。
先把正式與測試訂單一起列出來:
.local/admin-cli/publish/shop-admin list --source order --type all --all-pages --format txt
原始輸出(完整 TXT):
命令: list 來源: order
有效條件: purpose=all, memberId=未知 (null), from=未知 (null), to=未知 (null)
查詢時間: 2026-10-24T08:32:58.877976Z 請求頁次: 1
  符合條件總筆數 (totalCount): 2
  因未知時間排除筆數 (excludedUnknownTimeCount): 0
  訂單總額 (totalAmount): 338.0
  已知訂單金額 (knownTotalAmount): 338.0
  未知金額筆數 (unknownAmountCount): 0
金額涵蓋全部符合條件的訂單, 為保存金額, 非當頁合計或實收;all 含正式與測試。
跨請求讀取, 非原子快照;漂移檢查不能偵測所有並行變更。
頁次: 全部 每頁上限: 50 已讀筆數: 2/2
---
識別碼 (id): 2
會員 ID (memberId): 1
買方名稱 (memberName): andrew
用途 (isTest): normal (IsTest=false)
建立時間 (createdAt): 2026-10-24T08:05:22.61Z
保存金額 (totalPrice): 169.0
履約狀態 (fulfillmentStatus): succeeded
關聯結帳 ID (checkoutTransactionId): 2
---
識別碼 (id): 1
會員 ID (memberId): 1
買方名稱 (memberName): andrew
用途 (isTest): test (IsTest=true)
建立時間 (createdAt): 2026-10-24T08:01:31.038Z
保存金額 (totalPrice): 169.0
履約狀態 (fulfillmentStatus): succeeded
關聯結帳 ID (checkoutTransactionId): 1
這份輸出列出了全部 2 筆訂單, memberId 都是 1, 買方名稱也都是 andrew。不過, 訂單 #1 的 IsTest=true, 訂單 #2 則是 IsTest=false, 兩筆保存金額都是 169 元。這就把前面的操作串起來了: 同一個一般會員, 確實留下了一筆測試訂單與一筆正式訂單。
這裡的 purpose=all 同時包含正式與測試訂單, 所以 totalAmount 是 338 元。接下來把範圍限定為正式訂單, 看看統計會怎麼變:
.local/admin-cli/publish/shop-admin stats --source order --type normal --format txt
原始輸出(完整 TXT):
命令: stats 來源: order
有效條件: purpose=normal, memberId=未知 (null), from=未知 (null), to=未知 (null)
查詢時間: 2026-10-24T08:32:59.024207Z 請求頁次: 1
  符合條件總筆數 (totalCount): 1
  因未知時間排除筆數 (excludedUnknownTimeCount): 0
  訂單總額 (totalAmount): 169.0
  已知訂單金額 (knownTotalAmount): 169.0
  未知金額筆數 (unknownAmountCount): 0
金額涵蓋全部符合條件的訂單, 為保存金額, 非當頁合計或實收;all 含正式與測試。
條件改為 purpose=normal 後, totalCount 只剩 1 筆, totalAmount 是 169 元。這正是正式訂單 #2 的金額, 測試訂單 #1 沒有被算進來。
最後再查一次測試訂單, 確認它仍然可以獨立查核:
.local/admin-cli/publish/shop-admin stats --source order --type test --format txt
原始輸出(完整 TXT):
命令: stats 來源: order
有效條件: purpose=test, memberId=未知 (null), from=未知 (null), to=未知 (null)
查詢時間: 2026-10-24T08:32:59.158313Z 請求頁次: 1
  符合條件總筆數 (totalCount): 1
  因未知時間排除筆數 (excludedUnknownTimeCount): 0
  訂單總額 (totalAmount): 169.0
  已知訂單金額 (knownTotalAmount): 169.0
  未知金額筆數 (unknownAmountCount): 0
金額涵蓋全部符合條件的訂單, 為保存金額, 非當頁合計或實收;all 含正式與測試。
purpose=test 同樣查到 1 筆, 169 元, 對應測試訂單 #1。兩邊的 unknownAmountCount 都是 0, 表示這次沒有金額不明的訂單。測試紀錄有保留下來, 也能查到它的金額; 正式訂單統計則只包含正式交易。這裡統計的都是保存的訂單金額, 並非實際收款。
這組 CLI 查詢驗證的是訂單與統計。目前 CLI 沒有庫存查詢, 前面提到的庫存 100 → 100 → 97, 仍以每次結帳後的資料庫讀回結果為依據。以下節錄三份讀回檔案的 raw.Inventory, 只列出這次購買的啤酒 SKU:
00-baseline.json: "SKU-BEER-18D": 100
01-after-test.json: "SKU-BEER-18D": 100
02-after-normal.json: "SKU-BEER-18D": 97
會員的訂單列表也能看到這兩筆訂單, #1 標示測試用途, #2 標示一般用途。這對應到前面「身分與交易用途分開」的設計; 而只有正式交易扣庫存, 增加正式訂單總額, 則對應到「依交易用途控制商業效果」的要求。
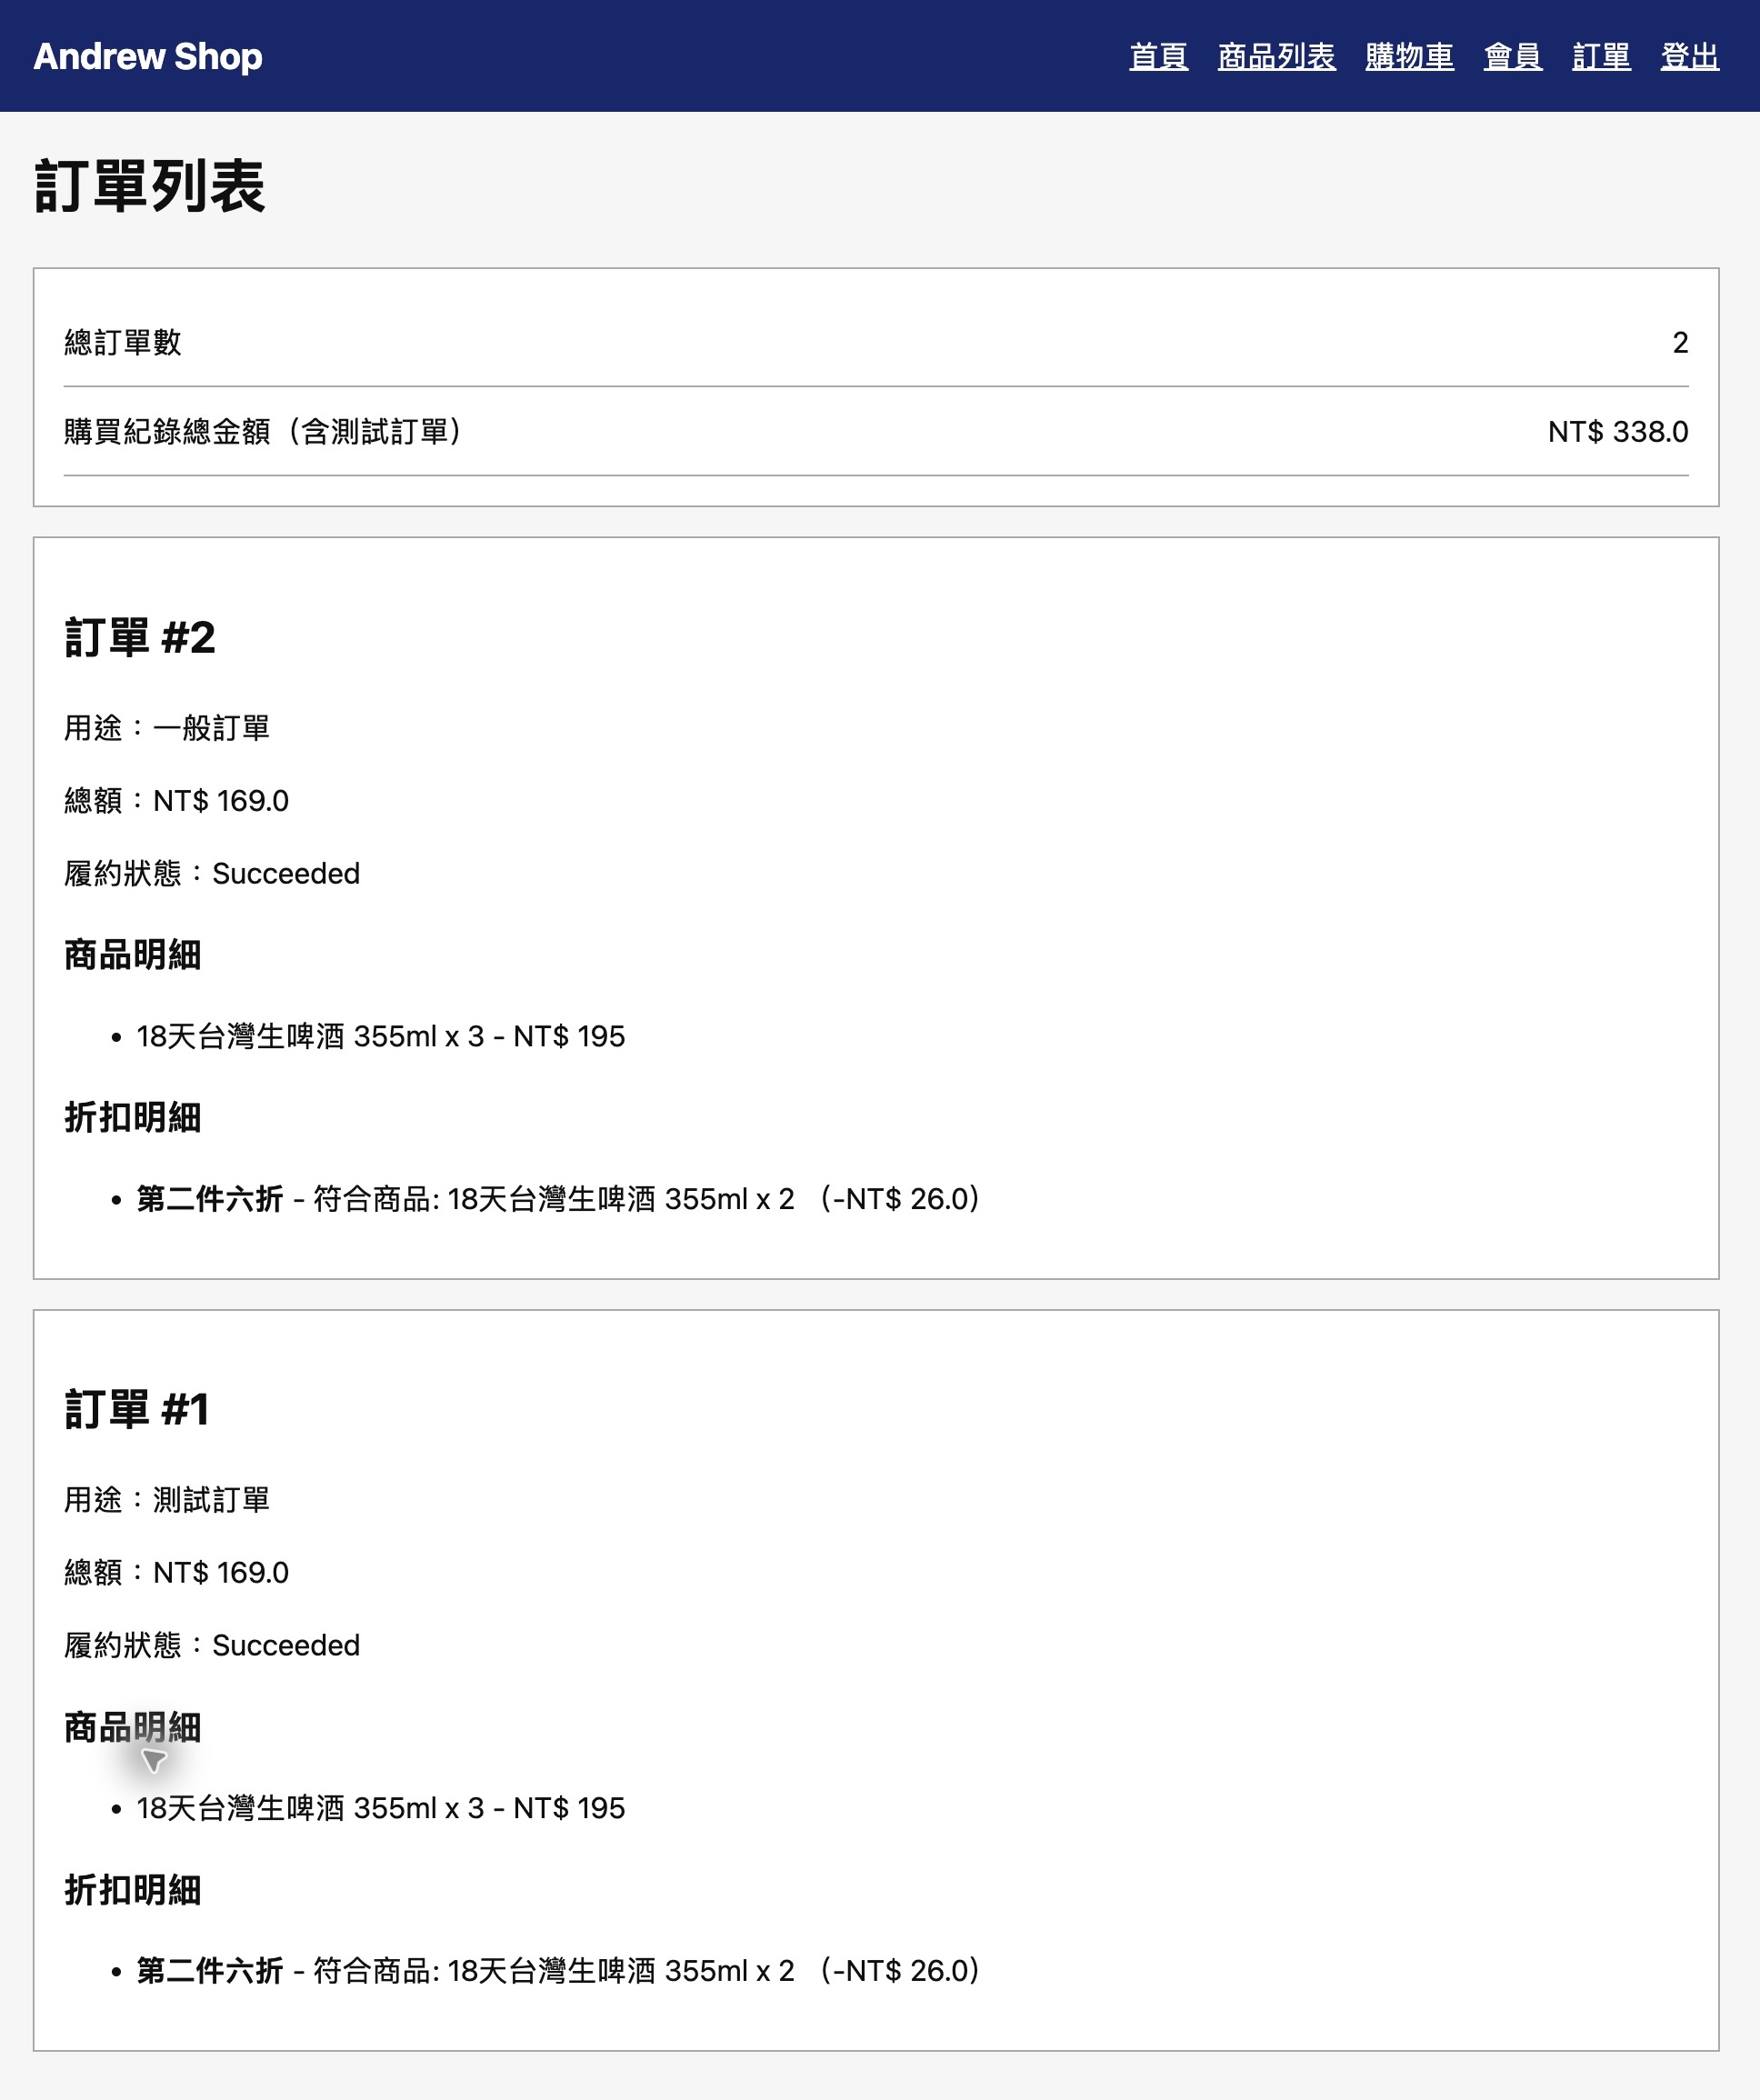
畫面上的「購買紀錄總金額(含測試訂單)」是 338 元, 包含這兩筆訂單; 管理查詢中的正式訂單總額則是 169 元。兩個欄位統計的範圍不同。
對我而言, 這就是這次 Test Mode 想達到的使用體驗: 拿商店原本的商品與優惠資料, 走完有意義的購物流程, 得到可以查看, 可以追查的測試結果。把畫面與實際資料對起來, 才能確認前面寫下的規格, 確實有落實到每一筆交易的行為上。
6, 開發設計心得總結
其實這篇, 除了講主軸 Test Mode, 從架構師的角度來看怎麼設計能支持在 production 環境進行局部測試的做法之外, 另一個角度 (私心), 其實這是我在 DevOpsDays Taipei 2026 這場演講的後半部補完。
Andrew Shop 就是我為了這場演講準備的 side project, 這次補完了 test mode + admin cli, 算是完成我想展示的最後一塊拼圖了, 而寫這篇文章的過程中, 中間有一大段 (第四章, 第五章) 的主要內容都是由 agent 準備 (包含測試的執行) + 撰寫完成的, 能做到這點的原因, 並不是我用了什麼厲害的模型或工具 (我就很普通的, 用了 codex + astra 而已), 只是這個禮拜 open ai 幾乎每天都在 reset 額度而已 XD
6.1, Core Context:
寫這篇的過程, 我也完全自己印證了我演講提到的觀念, 我在這邊重新整理一次:
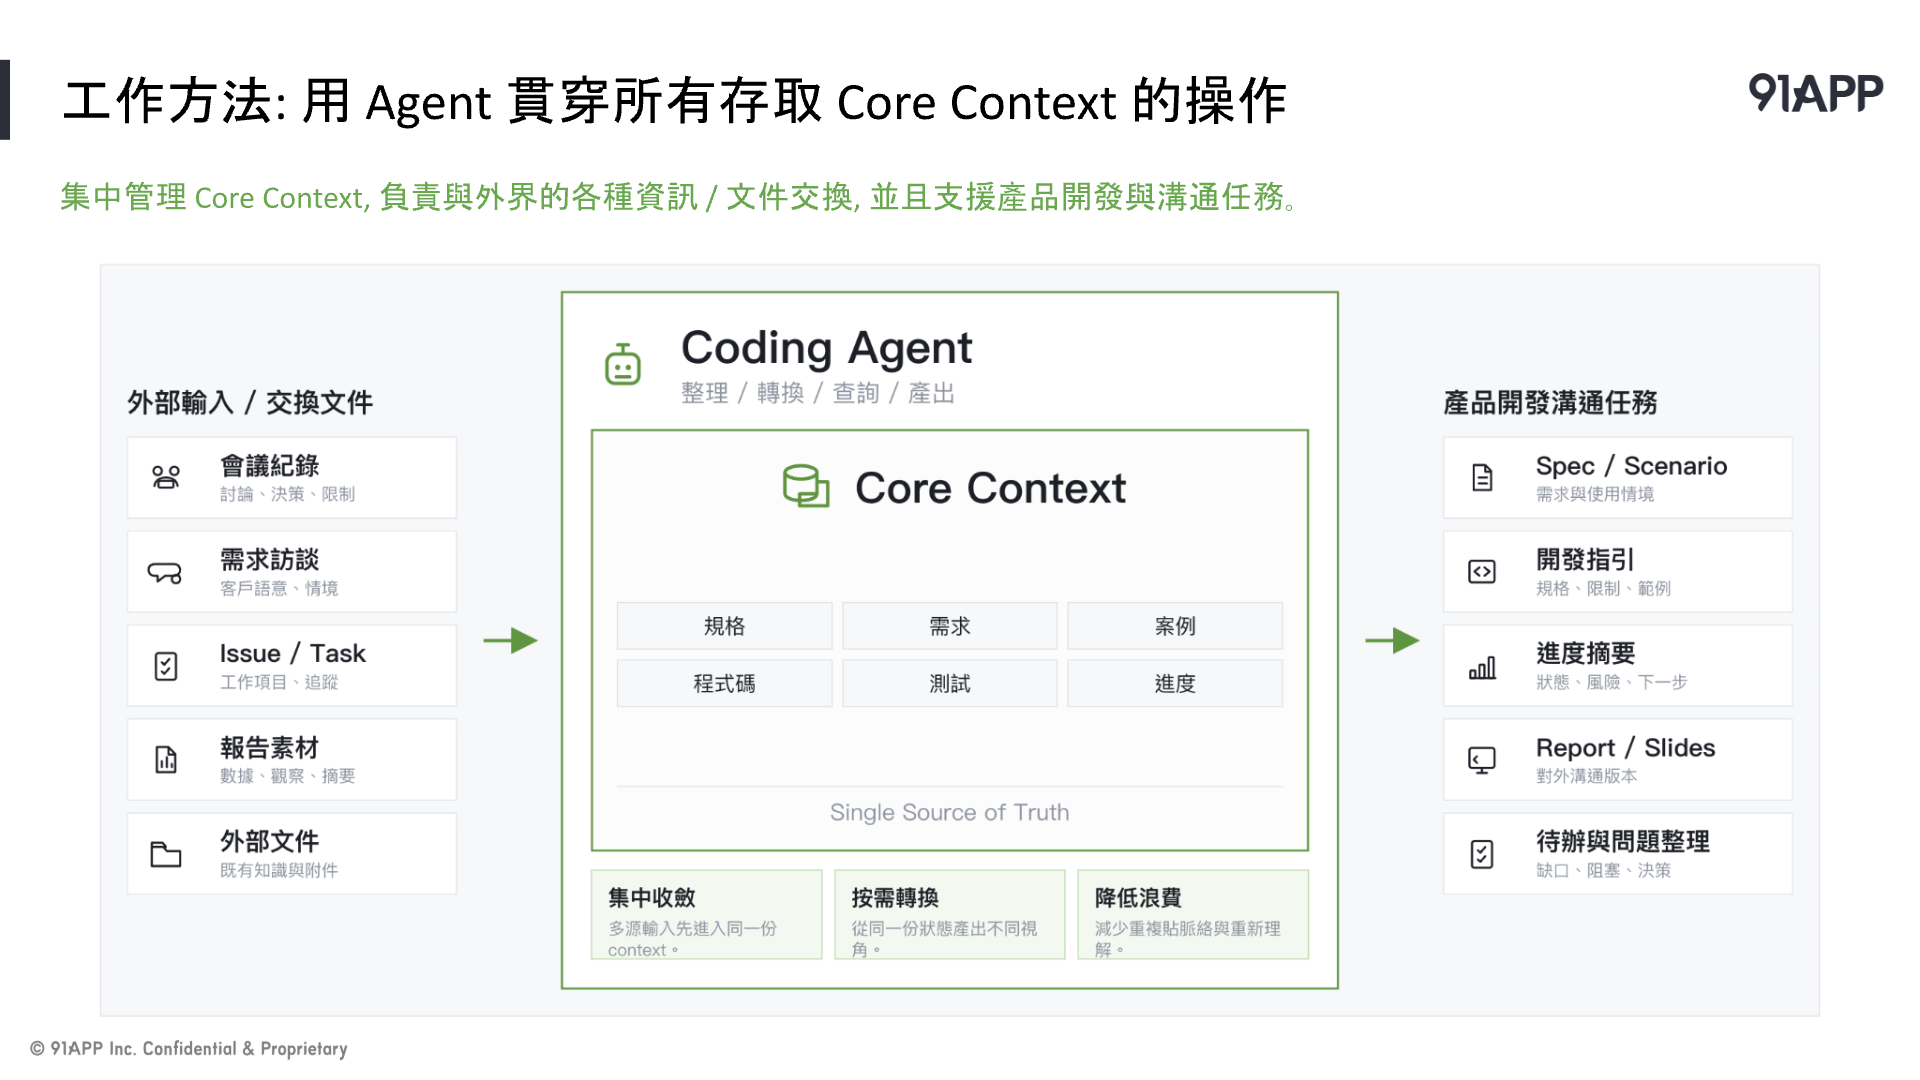
這頁說明集中管理高品質 (精確, 呈現事實, 沒有雜訊) 的 Context 的重要性, 當你的 Context 夠完整時, 你會發現每個人都能用這些 Context 高效率的完成自己的任務.
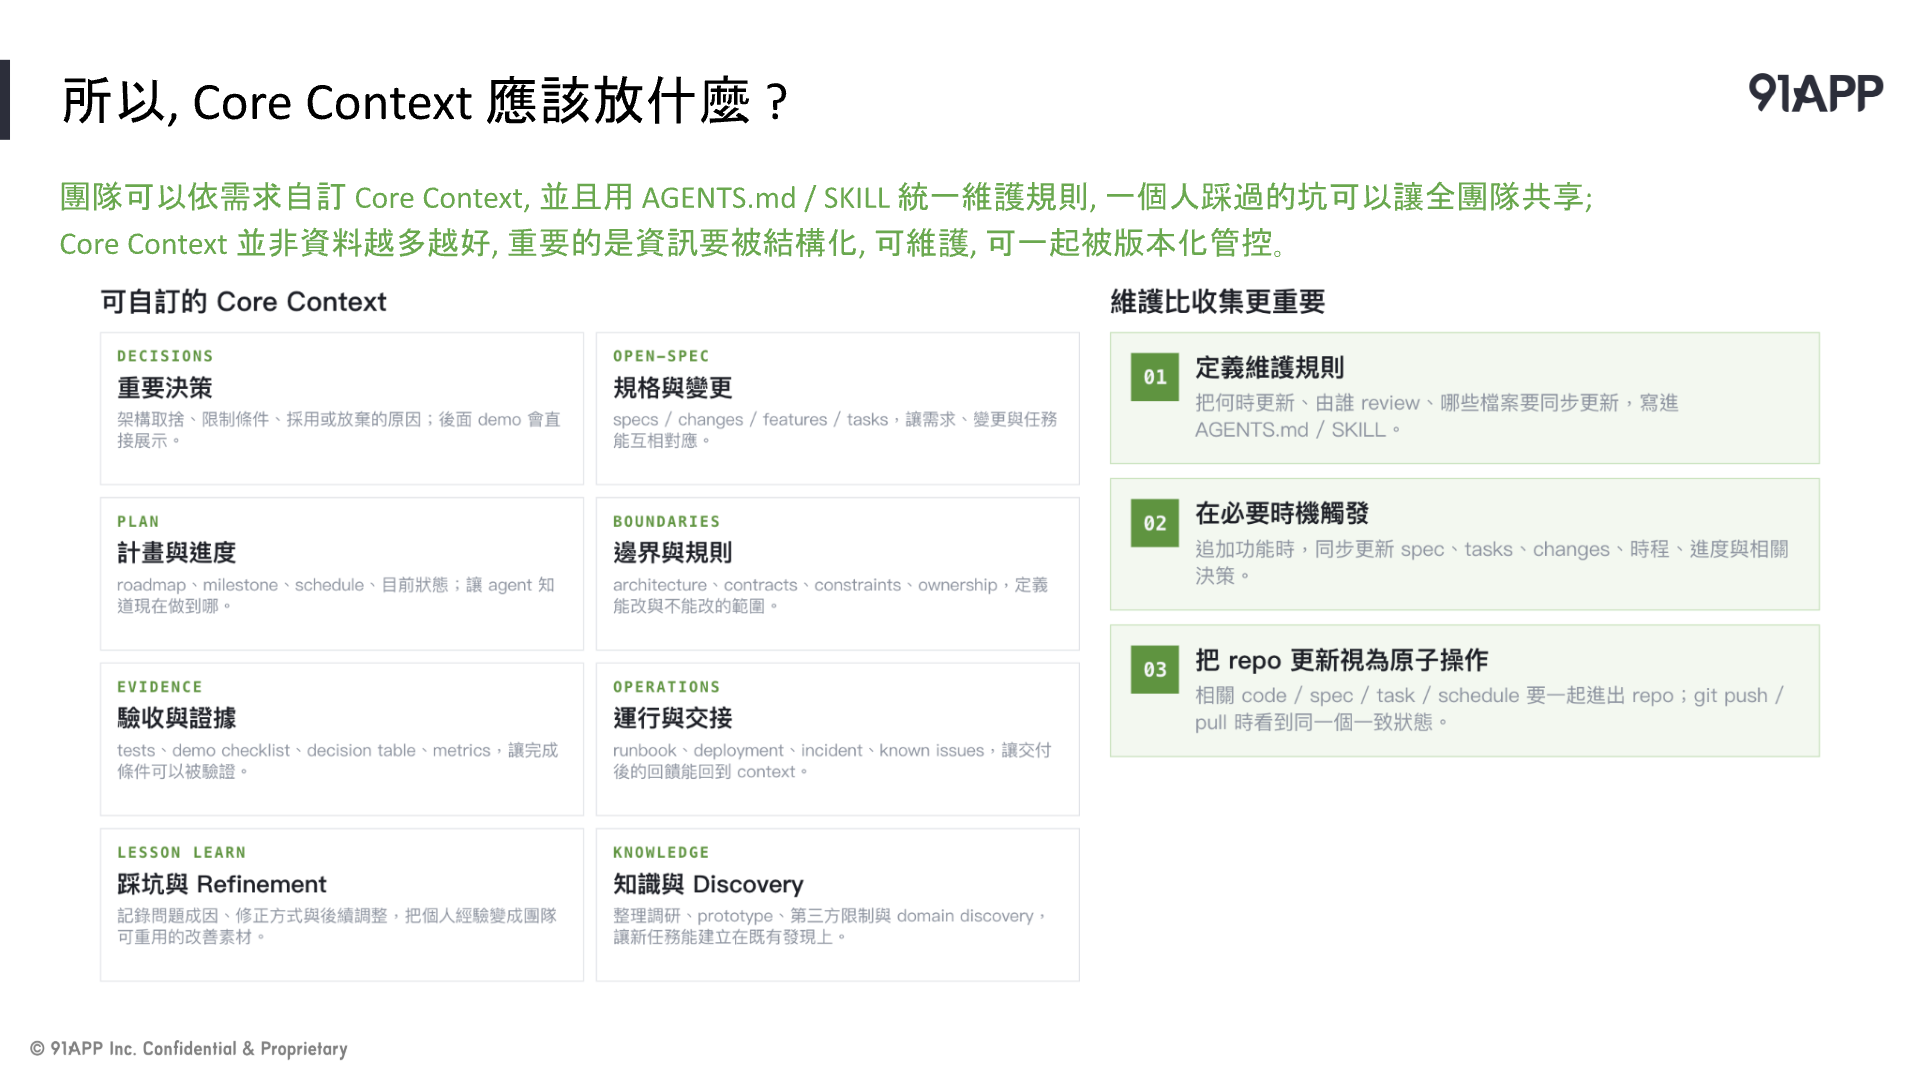
我在這次 side project 的範圍內, 擺了 “重要決策”, “計畫與進度”, “驗收條件”, 而程式碼與部署的方式 (包含本地 docker compose 部署) 也都提供了, 因此 agent 也有能力在本地端啟動, 並且按照驗收條件幫我驗證成果, 並且把我要的內容寫進文章內
文章只有真正要論述我心裡的想法的部分, 是需要我親筆撰寫的, 所以我特別在這篇文章明確標示了哪些是 agent 替我準備的內容, 目的不是強調純手工有多重要, 而是在這邊我想讓大家體驗, 人 + agent 協作的正確方式與可行性
6.2, 邊界規格的重要性:
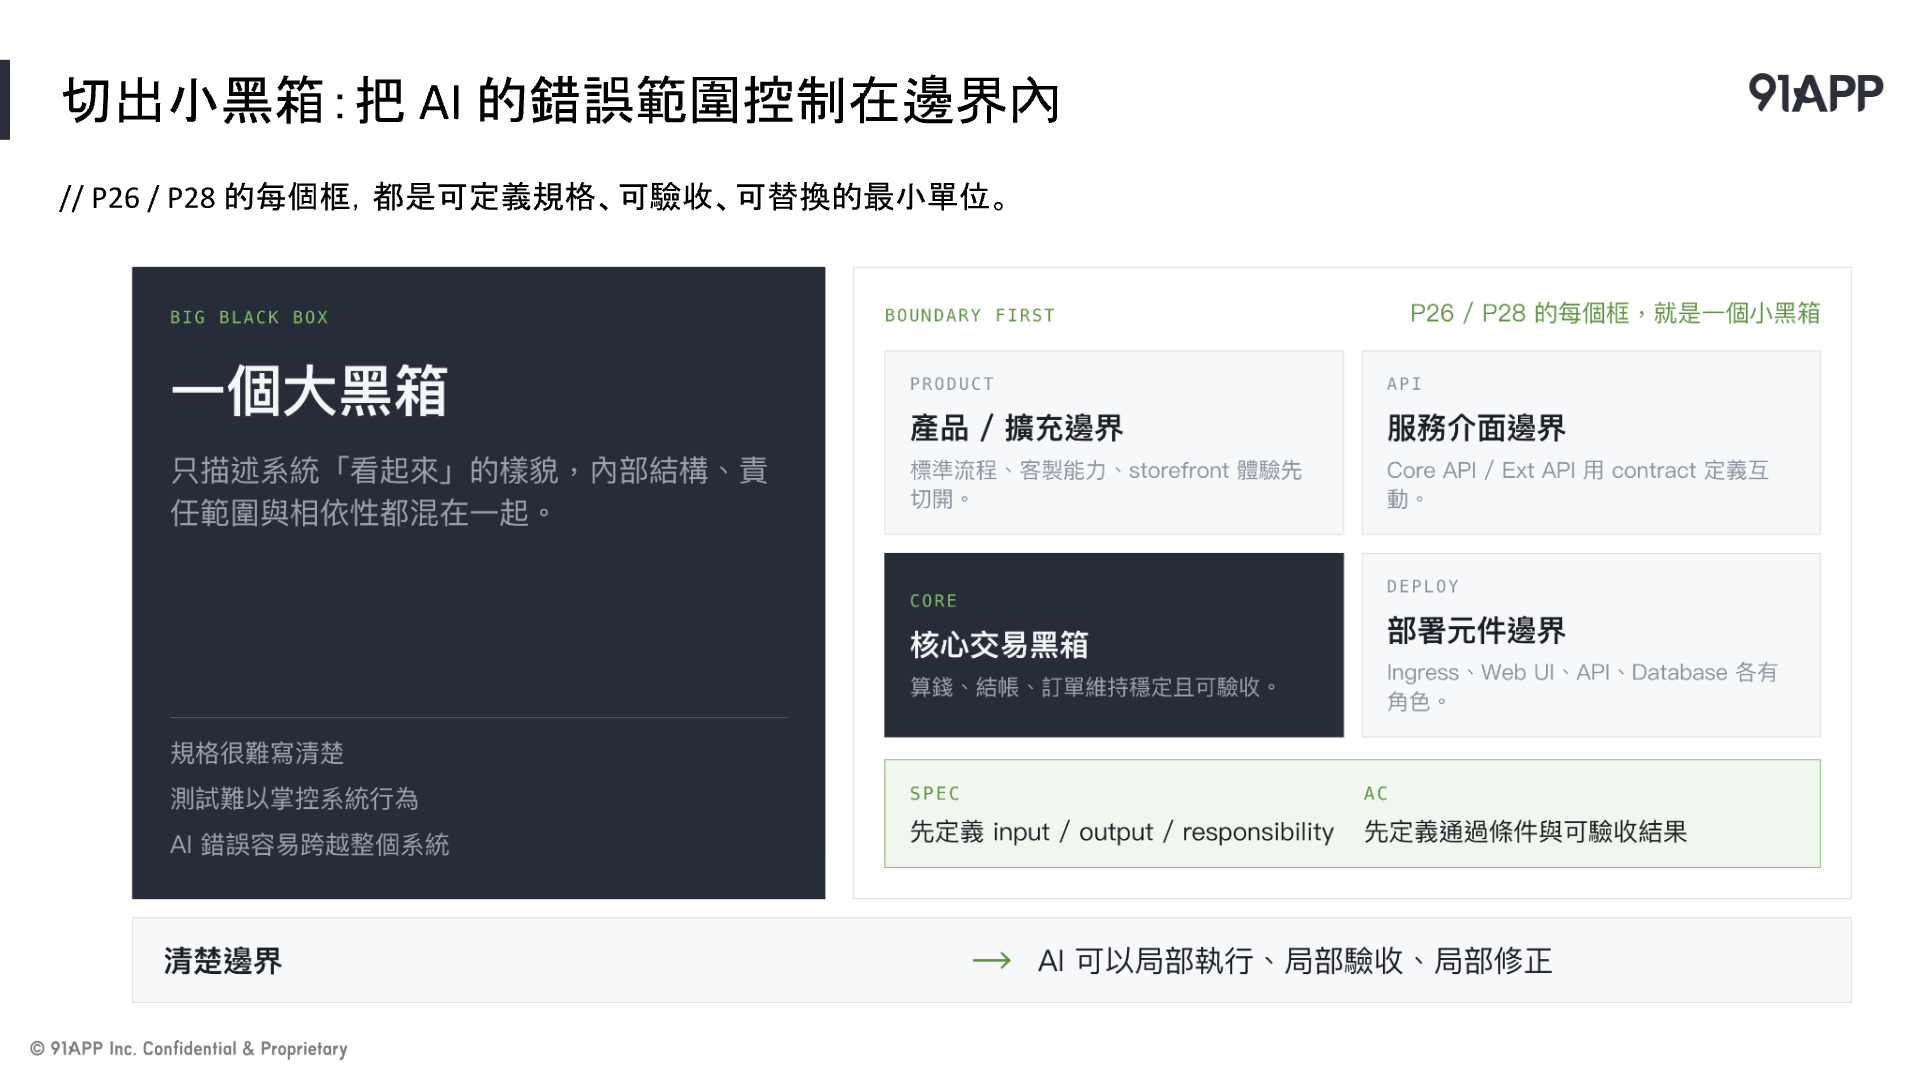
從 AI 盛行開始, 我不斷的用各種角度來說介面的重要性, 這次算是我覺得最具體的一次說明與示範了。 “Test Mode” 本身就是個難題, 我也看過太多案例, 沒有整體規劃, 每個功能都自己實作類似 “Dry Run” 的功能, 結果就是最後資料清理不夠乾淨, 有時這個報表會混進 Test Mode 的資料, 有時那個報表統計會漏算了 Live Mode 的數據等等
這些都是 “邊界” 的問題, 而更重要的是隔開多個黑箱中間的邊界, 控制好邊界, 黑箱就容易隔離並實作, 從微服務開始, 邊界就一直是個重要的技巧, 到現在 agent coding 也仍然是, 這次我明確的定義邊界, 把整個 Test Mode 運作的體系勾勒出來, 後面的開發跟實作就變的很容易, 幾乎是一次到位就完成 (只要邊界夠明確, 就算失敗了 agent 會有能力感知, 就會自己修正了, 因此對我而言也算一次完成 XDD), 完成這個案例, 對我而言也算把這個觀念做了一個完整的交代
6.3, Admin Console / CLI:
這是最後一個主題, 也是我在演講當時, 沒能來得及示範的主題。 這邊我貪心一點, 我放兩頁簡報:
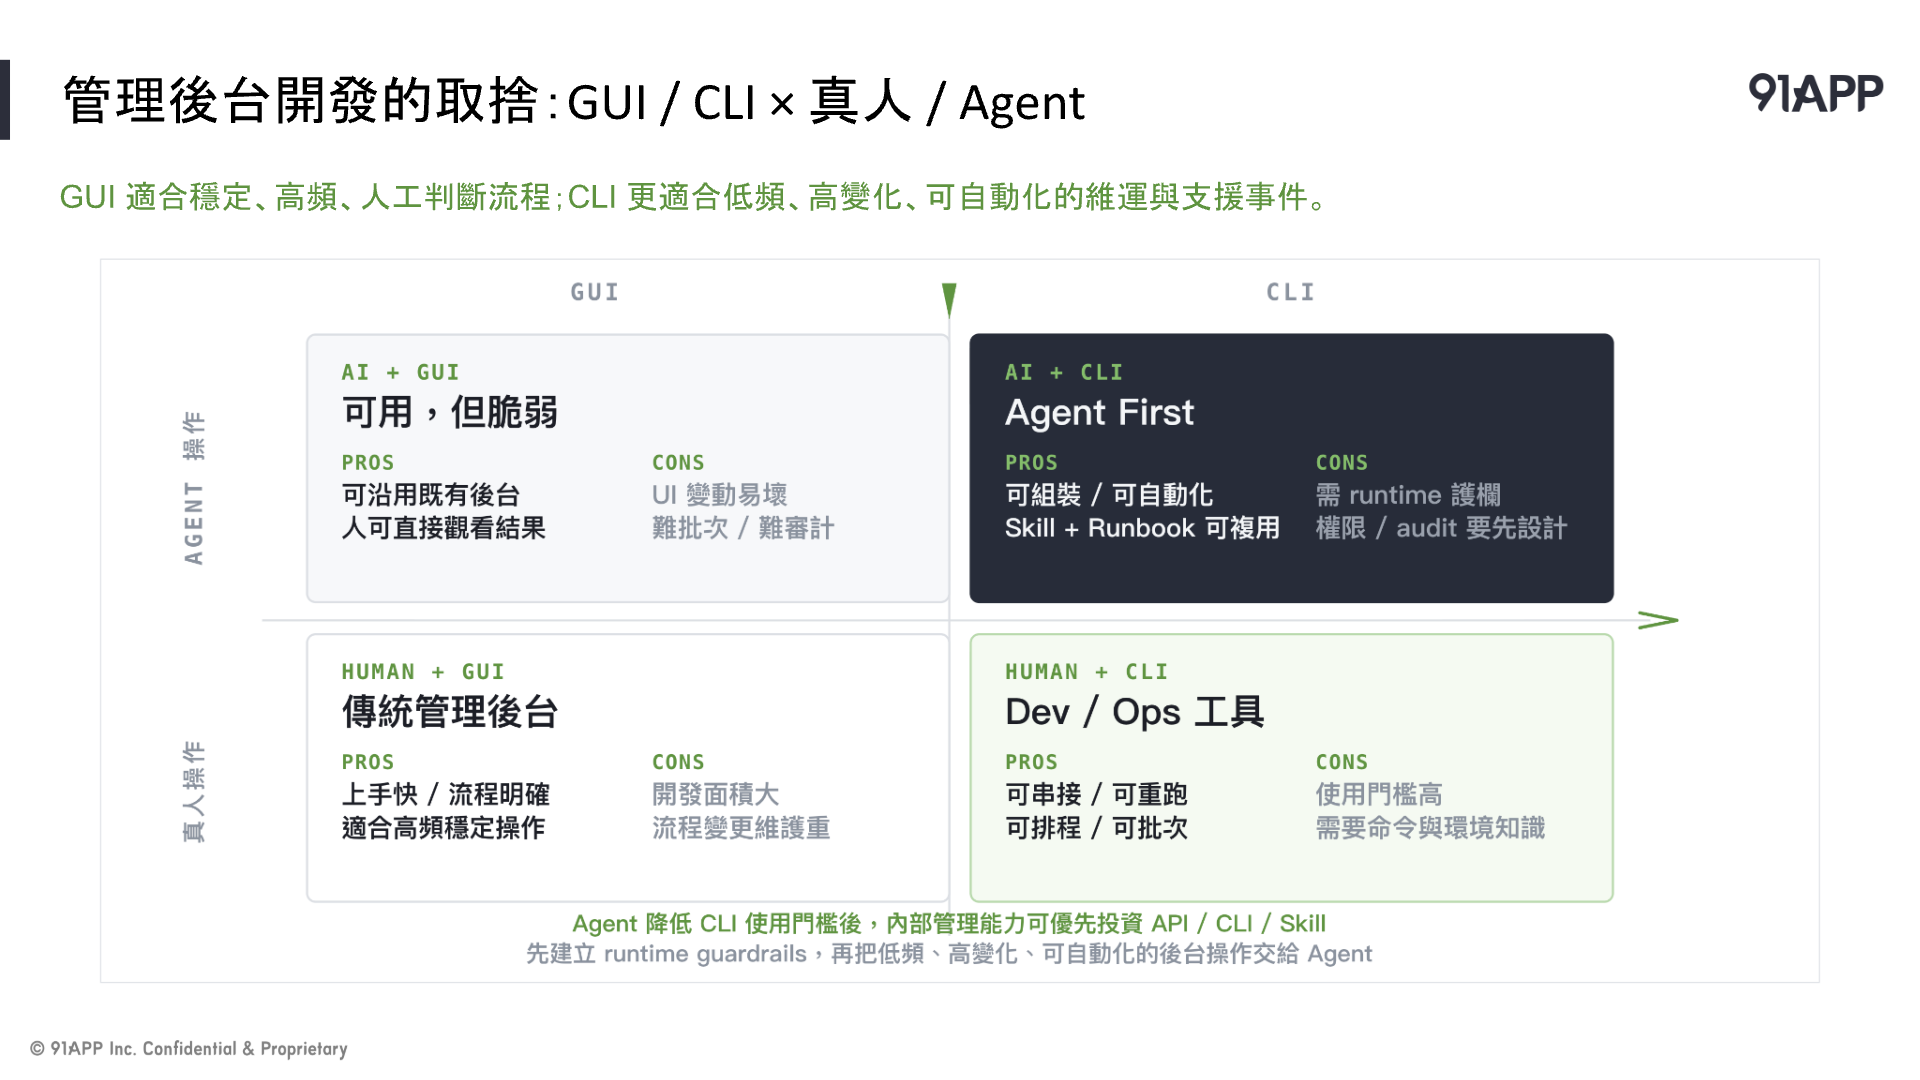
這頁講的是管理後台的取捨, 對於低頻, 高變化, 可自動化的維運與查核工作, CLI 更適合搭配 agent。 但是讓人直接用 CLI 門檻很高, 導入困難, 所以過去一直不是主流, CLI 淪為配角; 當你讓 agent 接手後, 就完全不同了, 我認為這類工作可以優先投資 API / CLI, 而 GUI 則保留給穩定, 高頻, 需要人工判斷或高度視覺化的部分 (報表, 指標呈現等等)
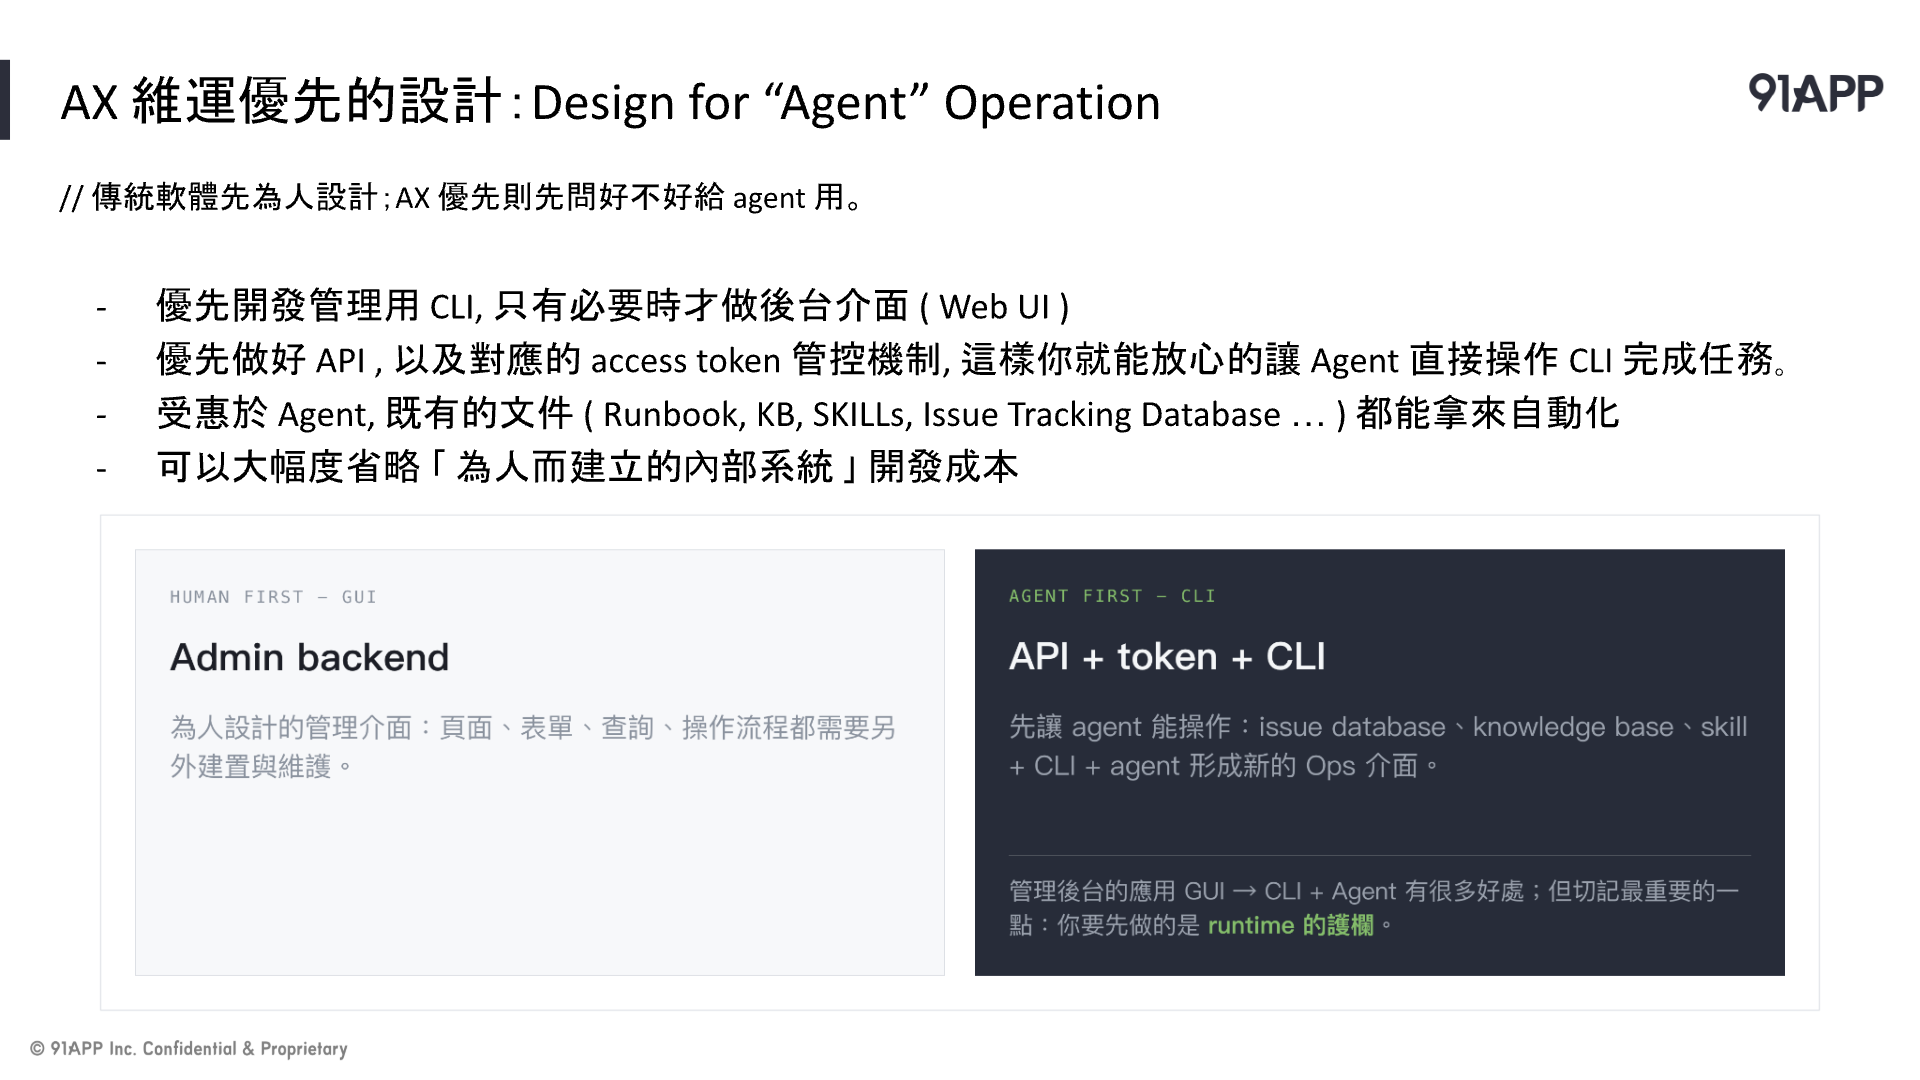
而這頁, 則是帶出, CLI 終究只是層 “介面”, 你的 CLI 能做多少事情, 完全取決於你後面的 API 有多厲害, 安全與授權管控的機制做的多到位。 CLI 之所以能比 GUI 靈活, 關鍵在於 CLI 能確實完成很多基礎操作, 而使用 CLI 的人能夠搭配 script 快速組合並重複這些基礎操作, 來完成複雜的大型任務, 因此這些基礎操作做的夠不夠確實 (效率, 可靠度, 甚至是指令的設計是否清楚, 狀態是否明確等等), 這些都會反映出 API First 的基礎能力有沒有到位
講到 API First, 我也有一堆東西可以講 XDD, 不過那些我都寫過多篇文章了, 大家自己往前翻… (API First 的開發策略, 從 API First 到 AI First)
最後分享一個我自己的 CLI 設計技巧, 一般按照慣例, CLI 用 –help 就會列出使用提示, 大家都會這樣設計吧? 讓使用者知道有哪些參數能用 (當然 Agent 也能看), 我拿這次的 admin-query cli 當案例:
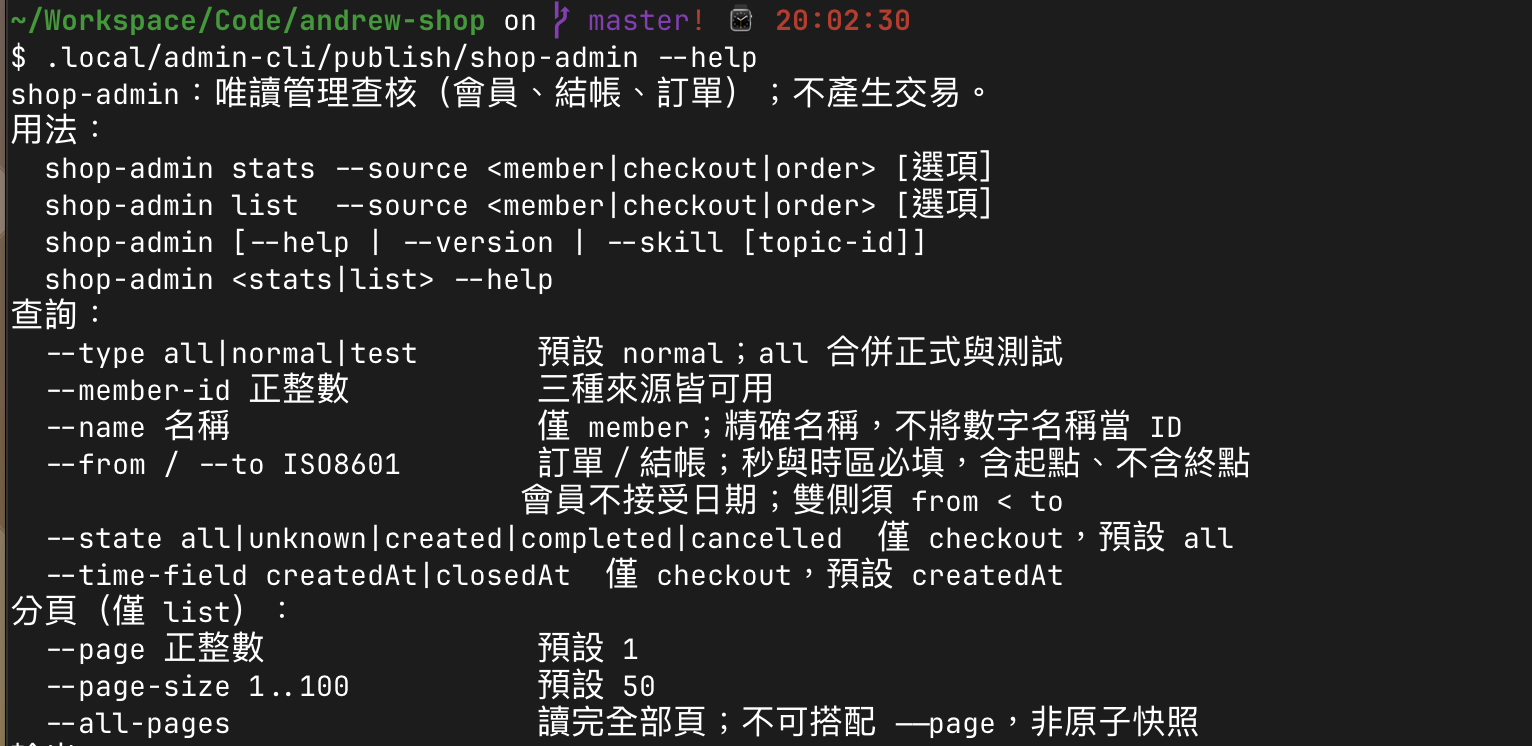
不過, CLI / SKILL 要維持同步更新, 並且部署到所有使用者端的環境, 兩條不同的部署路線其實還挺麻煩的, 我用了點小技巧把 SKILL 封裝到 CLI, 用 –skill 來調出內容, 這是給 agent 看的 help, 引導 agent 怎麼有效率的使用這 CLI 的指引
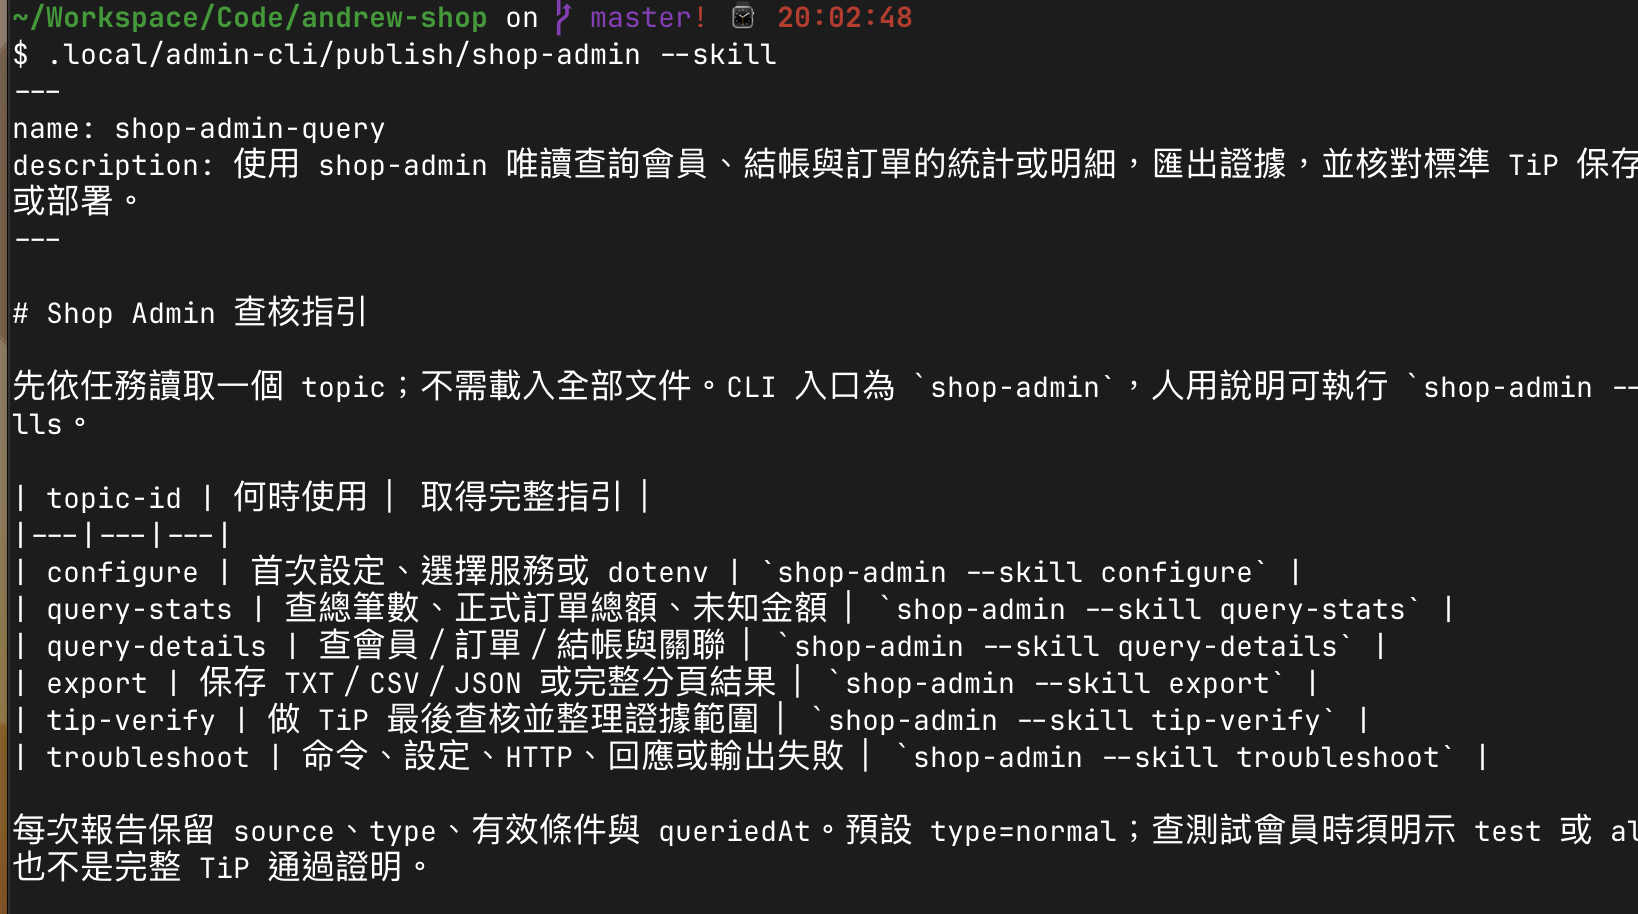
這是我自己的設計技巧分享, 重點是讓 CLI 與操作指引跟著同一個版本一起部署, agent 需要時就能取得對應的用法。
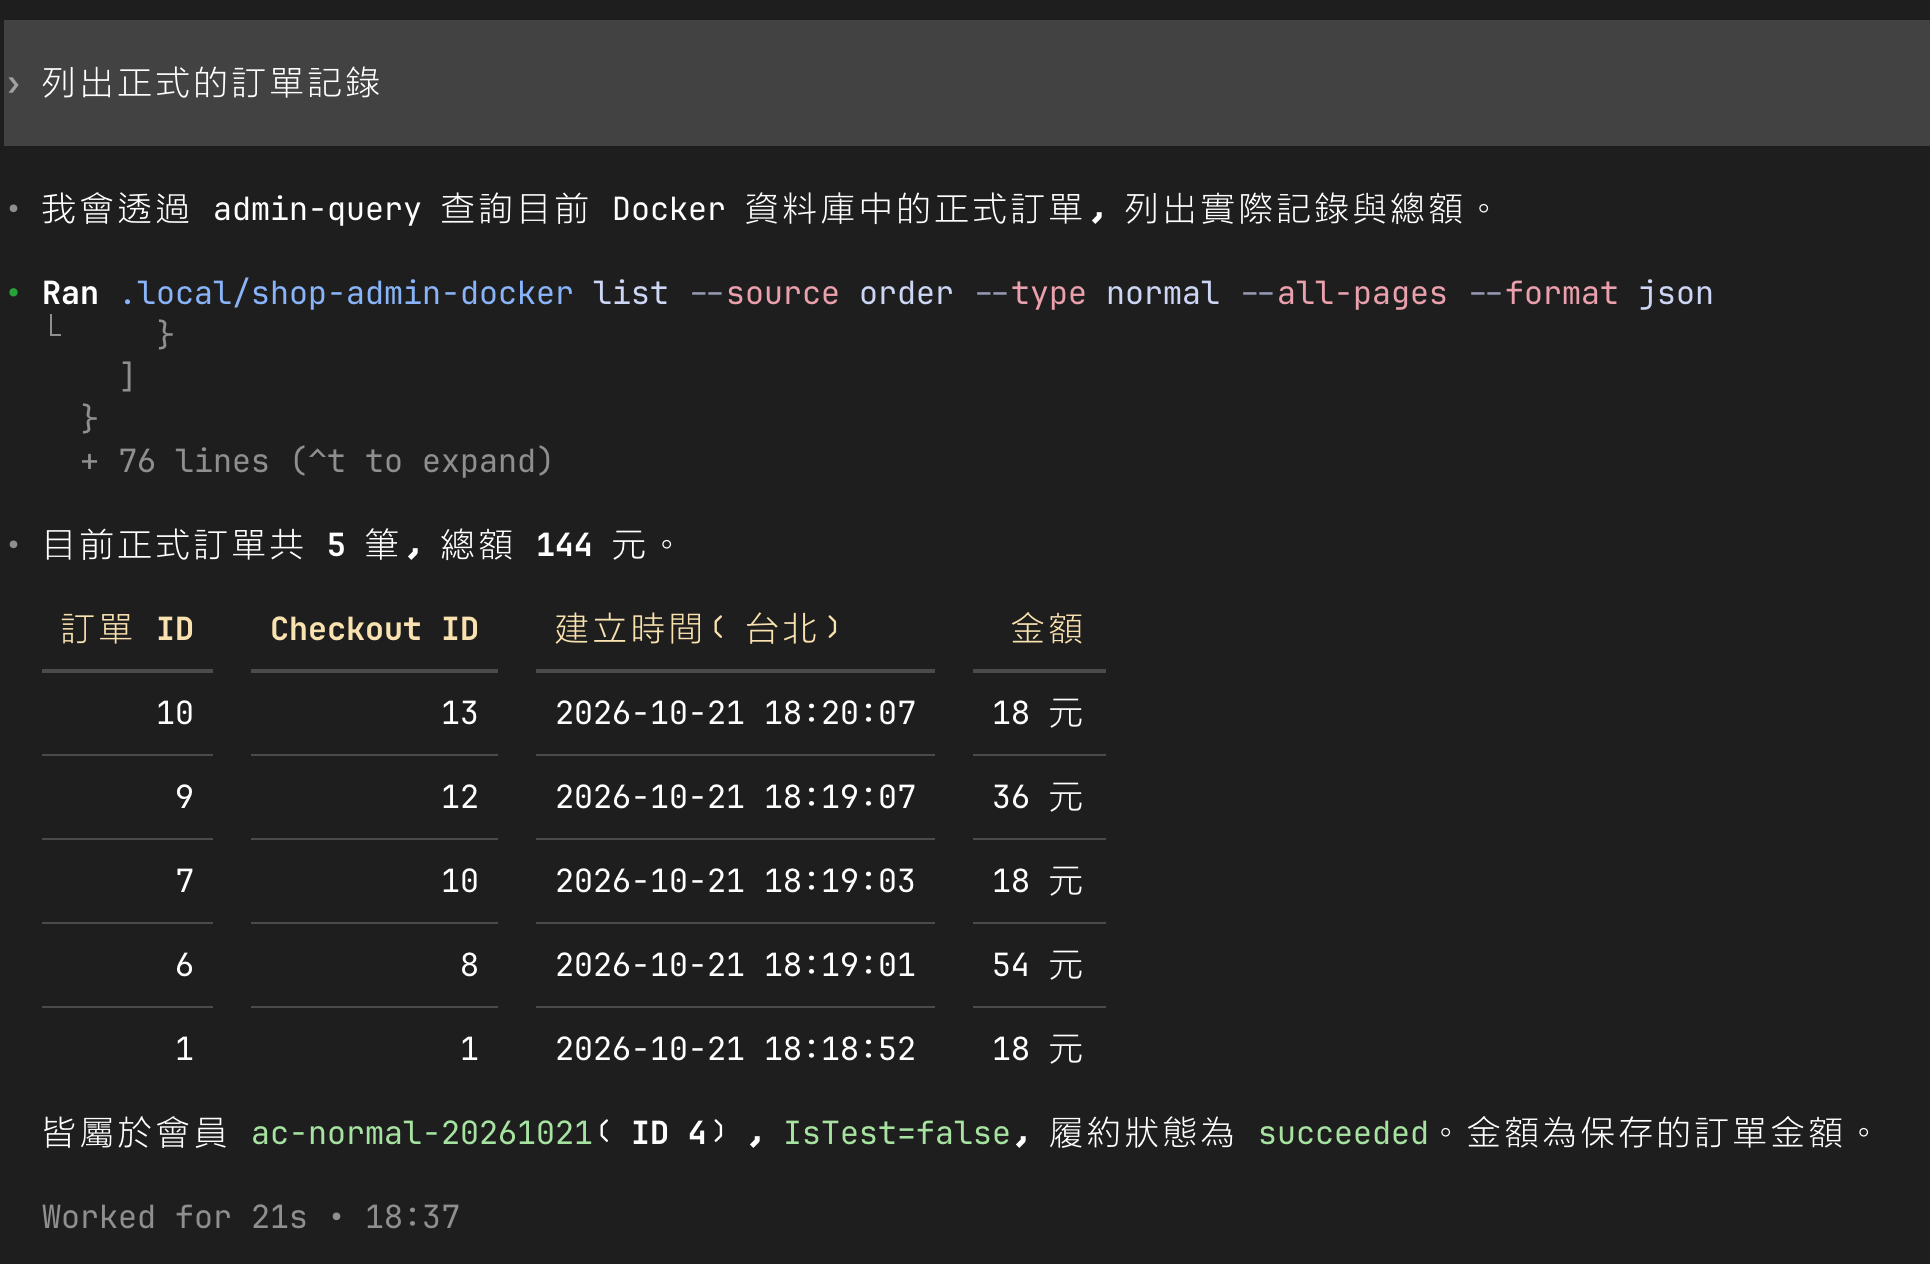
當 agent 熟悉你的 CLI, 也有足夠的 Context 時, 一句話就能完成這類查詢。 下面是另一次對 Docker 環境既有訂單的查核, 查的是 2026-10-21 留下的資料, 共 5 筆正式訂單, 144 元; 與第五章的 demo 是不同資料集:
6.4, 總結 & 參考連結
回到這篇最開始, 我抓這個主題的企圖, 就是解決測試跟資料的兩難而已。 現在的服務, 使用者已經不只是真人而已, 要讓 agent 操作的比例越來越高了, 而這類應用, 服務背後的資料庫已經是 context 的一部分了, 不管是功能的測試, 或是客戶 / 開發者的評估, 沒有 context 的話, agent 相關的驗證跟測試就沒有意義了, 所以我才再度挖出過去被我放棄沒有好好研究的題目: Test Mode in Application 的設計方式, 同時也把這概念, 順利的加到 Andrew Shop, 我先前研究跟練習架構設計用的 side project, 並且真的能通過驗證跟測試, 可以在同一個環境執行正式的交易邏輯, 也能用不同的信用卡卡號切換到測試的交易邏輯, 並且在實際的資料庫設計跟程式碼架構, 把這些路線清楚的隔離出來, 這一切成果, 都符合我設計的期待。
兩週前我在 Hello World Dev Conference 聽了 Jed Lin(林承毅)的演講「當架構設計被 AI 加速後, 工程判斷力的養成與傳承該怎麼辦?」, 其中講到這段話 (我忘了原文, 只能憑記憶回想), 大意是:
決策有分兩大類, 一種是很容易重來的, 可以放心的交給 AI 讓他全速跑; 另一種是做錯決策就很麻煩的, 你需要花時間設計, 思考, 評估的決策, 應該要仰賴有經驗的人決定後再交給 AI 補完; 而在中間地帶, 還有一類是決策容易重來, 但是變更的執行成本很高的 (例如: 內部評估用的 prototype, 要實作一個內部使用的 prototype 要寫很多程式碼, 卻又不能賣錢)… 這類決策過去往往難以頻繁的執行, 而現在有了 AI, 大幅降低 coding 的成本, 這類開始也適合讓 AI 來處理。
我會想起這段演講, 就是這題目過去我根本沒機會用閒暇時間做完 PoC 真的開發一遍啊, 這種 “刻意練習” 的題目, 就屬於中間地帶的類型, 過去很花時間的, 現在拜 AI 所賜, 我大約花了一天的時間, 就完成這次 Test Mode 的開發了, 趁著假期也把這篇心得記錄補完了。 這速度在過去是無法想像的, 這也是資深人員在 AI 時代新的學習方法。
在 DevOpsDays 的演講裡, 我也分享過這頁簡報:
當 AI 加速之後, 你應該多撥一點時間 (30%), 把他用在改善系統架構或是體質 (像是這次的重構), 以及多花一些時間 (10%) 來培養自己的能力。 而這篇文章, 這 30% + 10% 都涵蓋到了
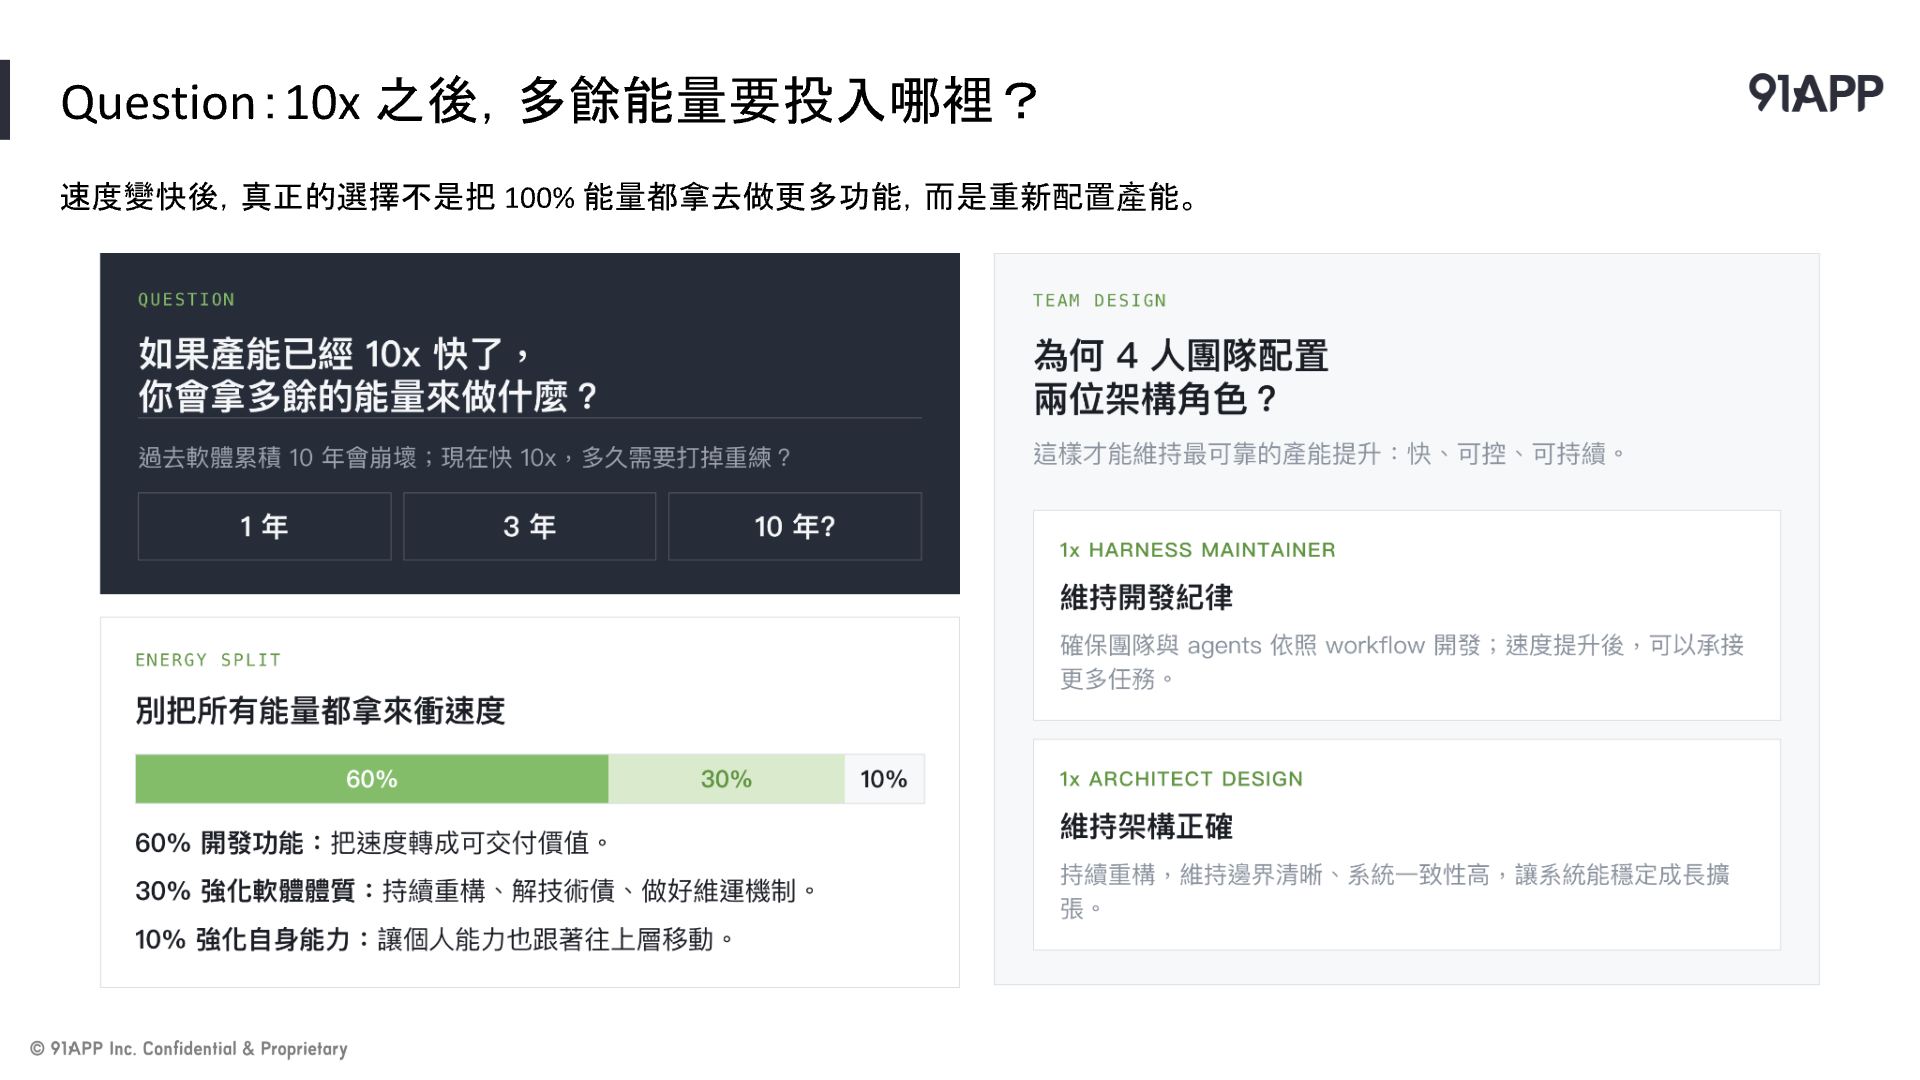
AI 越來越強, 不過如果你的能力沒跟上, 你是沒有機會處理 “架構與邊界設計” 這類需要先經過人工設計過再交給 AI 執行的任務的, 這也是之前我常常在推廣的 “刻意練習”, 用這種方式, 你一週就能掌握重要的觀念了, 如果要在實際專案學到這樣的經驗, 以我經驗來看, 至少是 3 ~ 6 個月規模的開發專案才有機會碰的到。 所以, 我刻意會花時間自己寫, 一方面也是要驗證我自己是否真的確實掌握這些 knwo how 了? 沒有充分理解, 寫的過程你自己會知道 (心虛), 就會回頭去把這些環節真正的搞懂, 這些能力, 才是未來能高度跟 AI 協作的必要能力吧
參考連結: 專案, 規格與實測資料
- GitHub repo: Andrew Shop。 目前整合分支為
master, 本文連結固定到本次修訂時的 HEAD commitf085e8c。 - 第五章 demo 當時使用的程式碼版本為
c67e2d3; 實測證據保存於191f9ee, 兩者皆已納入上述 master 版本。 - 設計與驗收: Test Mode 文件入口, 驗收條件 AC, 重要決策索引。
- 正式規格: Phase 1 規格, 測試案例。
- 操作與重現: 本機部署說明, AdminCLI 操作說明。
- 第五章實測: 完整執行記錄, CLI 命令與退出碼, 原始輸出與擷圖。
參考連結: 演講與延伸閱讀
- DevOpsDays Taipei 2026: 完整簡報, 前一篇文章 AI Era, 架構師的注意力該用在哪裡?。
- .NET Conf 2019: Scope 與跨執行邊界的 Context 範例(第 74 頁起)。
- Hello World Dev Conference 2026, Jed(林承毅): 當架構設計被 AI 加速後, 工程判斷力的養成與傳承該怎麼辦?。上面的演講心得是我的記憶整理, 非逐字引用。
- API 設計延伸閱讀: API First 的開發策略, 從 API First 到 AI First。
- 本文動機提到的 Facebook 討論: 以後的軟體是寫給 Agent 使用的。
參考連結: 廠商官方文件
- Salesforce: Sandboxes, Sandbox 類型, Change Sets, 方案定價。
- Shopify: 商店類型, Client transfer stores 的限制。
- Stripe: 測試指南, 測試環境比較, API 模式判定, API keys 與物件隔離, Webhooks。